印尼新Gmail IP
DESCRIPTION / 资源参数说明
本篇文章基于annotated-transformer的第一部分Model Architecture所做的综合笔记,代码的实现不止一种,网络上有其他更简明的且易于实现的,可以用以对pre-training过程进行了解。该笔记中的code仅作为一种深入理解model原理和机制的工具,并不作为实际training的code,故该篇文章后面两部分的内容或缺省或由其他笔记补充。annotated-transformerThe Illustrated Transformer 图解Transformer(完整版)Transformer的Decoder的输入输出Transformer模型详解(李宏毅版)详解Self-Attention和Multi-Head AttentionTransformer代码阅读面经:什么是Transformer位置编码?Transformer Architecture: The Positional EncodingLinear Relationships in the Transformer’s Positional Encoding【Transformer】10分钟学会Transformer | Pytorch代码讲解 | 代码可运行Attention Is All You NeedGenerating Sequences With Recurrent Neural Networks(自回归属性)DropoutPositional EncodingResidual ConnectionLayer Normalization
transformers总体布局如下,共分为五个部分:Encoder,Decoder,Inputs Embedding,Output Embedding和Geneator。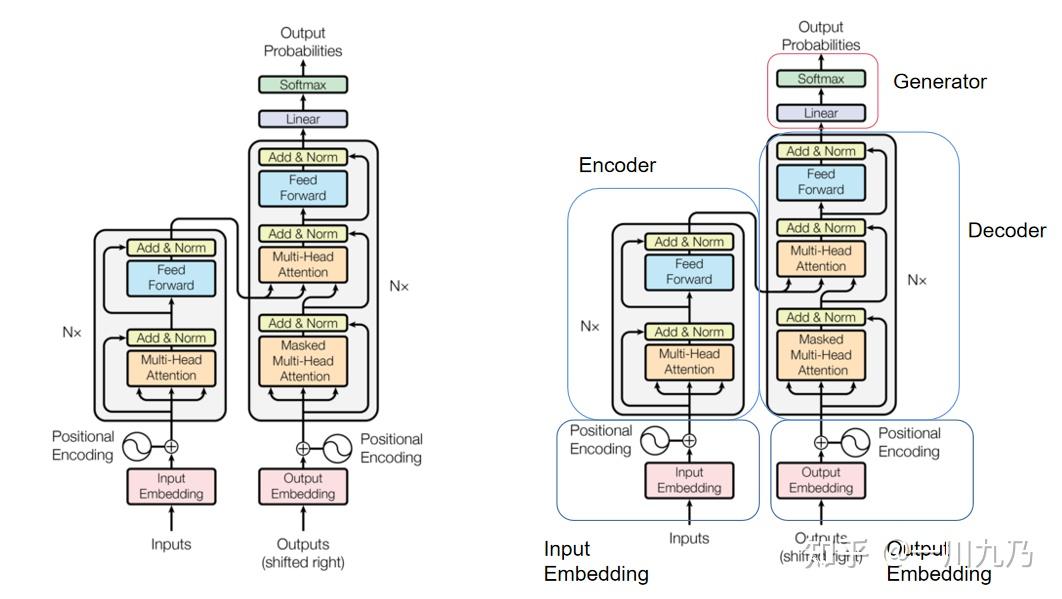 transformers_ar
初始化:self.encoder 编码器结构self.decoder 解码器结构self.src_embed 源嵌入self.tgt_embed 汇嵌入self.generator 生成器
在后续make_model function中通过如下语句调用生成实例:
后面对各部分进行分析。
生成器模块做的是线性变换+softmax,该部分位于Decoder输出后和最终输出Output Probabilities之间,作用是将decoder的隐状态输出对应的词,其中d_model为Decoder输出的大小,vocab为词典的大小,便是利用全连接来将decoder输出转化为词表大小的结果,并通过softmax转化为每一个词的概率。
self.proj = nn.Linear(d_model, vocab)用法细节补充:1)nn.Linear是一个类,使用时进行类的实例化;PS: 这里注意python中class和function在书写上区别不大,但在使用上有差异。后者是调用,前者是实例化。2)实例化的时候,nn.Linear需要输入两个参数,in_features为上一层神经元的个数,out_features为这一层的神经元个数,batch不变(batch相当于除最后一位维度大小的其他位),参考使用例。3)不需要定义w和b。所有nn.Module的子类,形如http://nn.XXX的层,都会在实例化的同时随机生成w和b的初始值。所以实例化之后,我们就可以调用属性weight和bias来查看生成的w和b。其中w是必然会生成的,b可以控制是否生成。在nn.Linear类中,有参数bias,默认 bias = True。如果不拟合常量b,在实例化时将参数bias设置为False即可。4)由于w和b是随机生成的,所以同样的代码多次运行后的结果是不一致的。如果我们希望控制随机性,则可以使用torch中的random类。如:torch.random.manual_seed(420) 人为设置随机数种子5)由于不需要定义常量b,因此在特征张量中,不需要留出与常数项相乘的那一列,只需要输入特征张量。6)输入层只有一层,并且输入层的结构(神经元的个数)由输入的特征张量X决定,因此在PyTorch中构筑神经网络时,不需要定义输入层。7)实例化之后,将特征张量输入到实例化后的类中。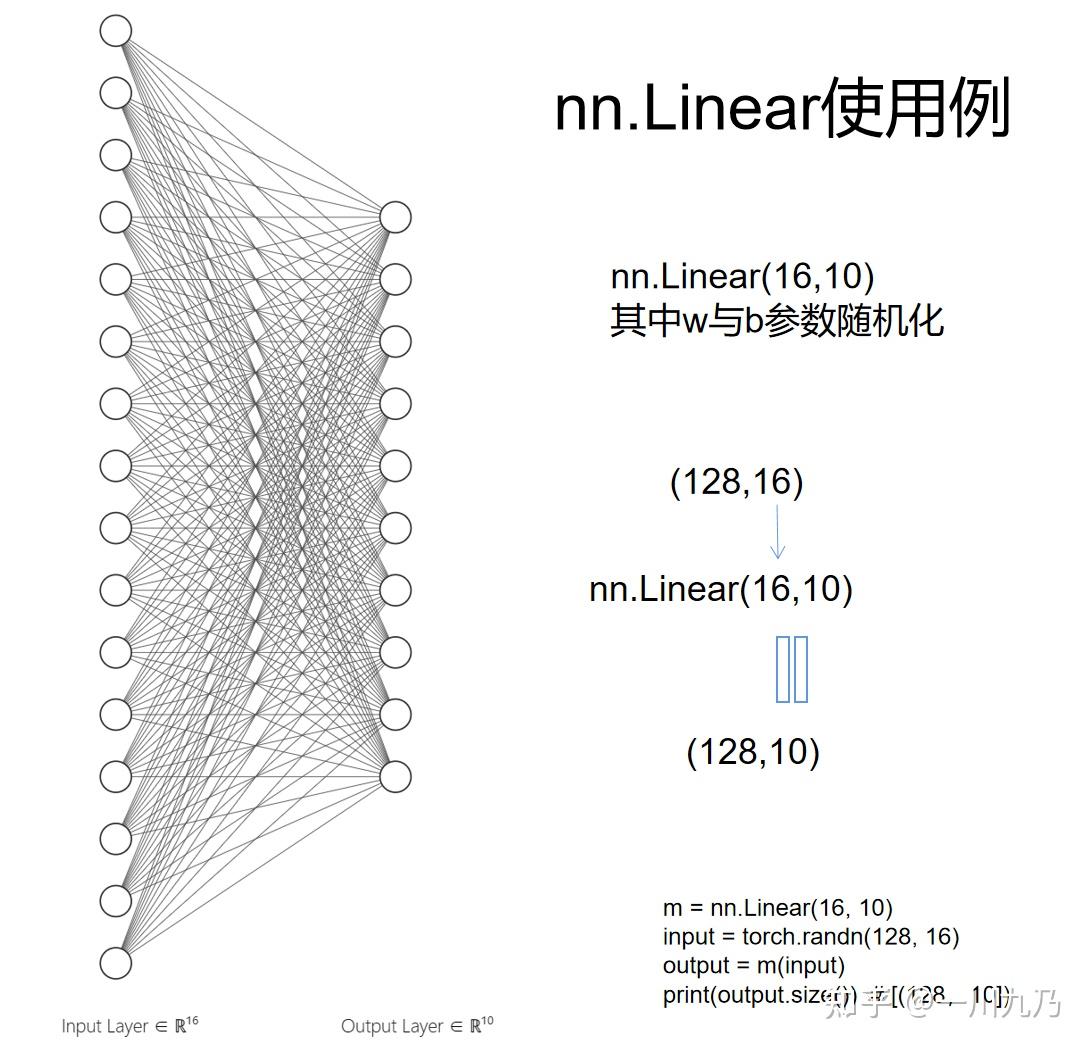 nn.Linear
python class的调用过程跟C++相似,如下情况当运行即实例化时,执行class中的function,再执行基类Foo。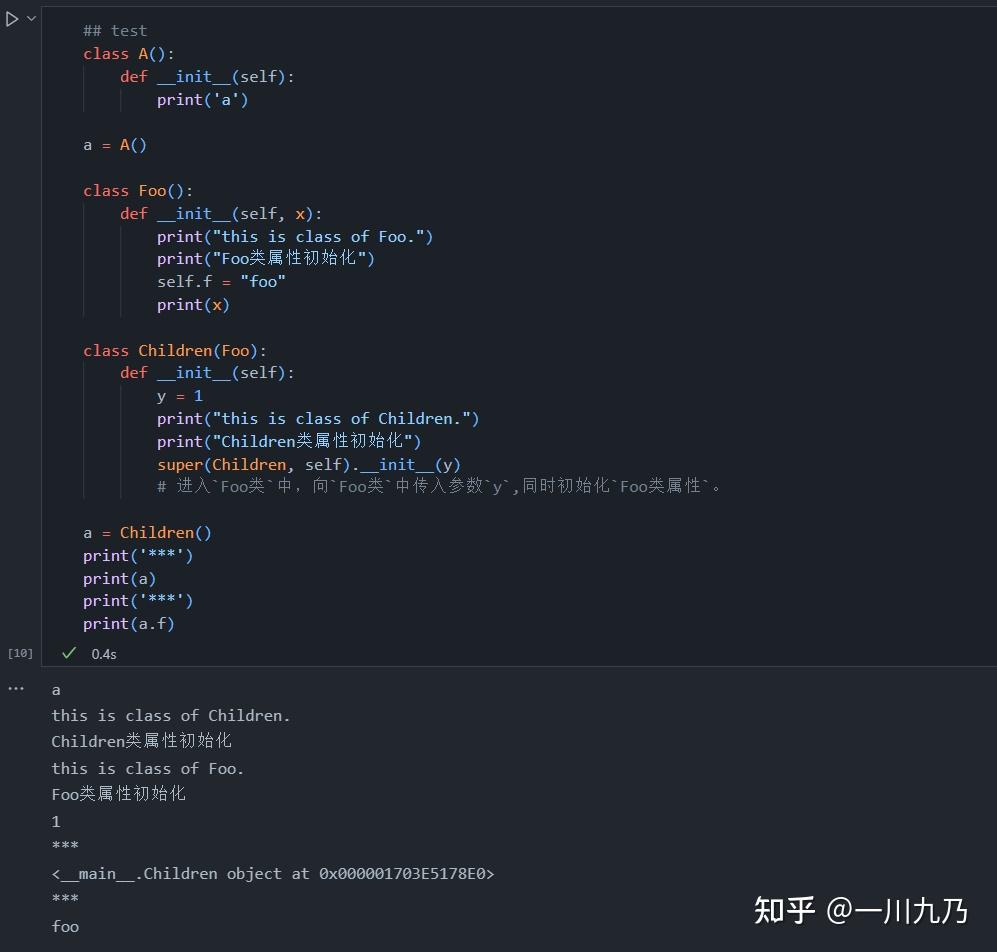 python顺序
除了function,还有function,该function只有在实例被调用时才被运行。而forward便是依据function来调用的: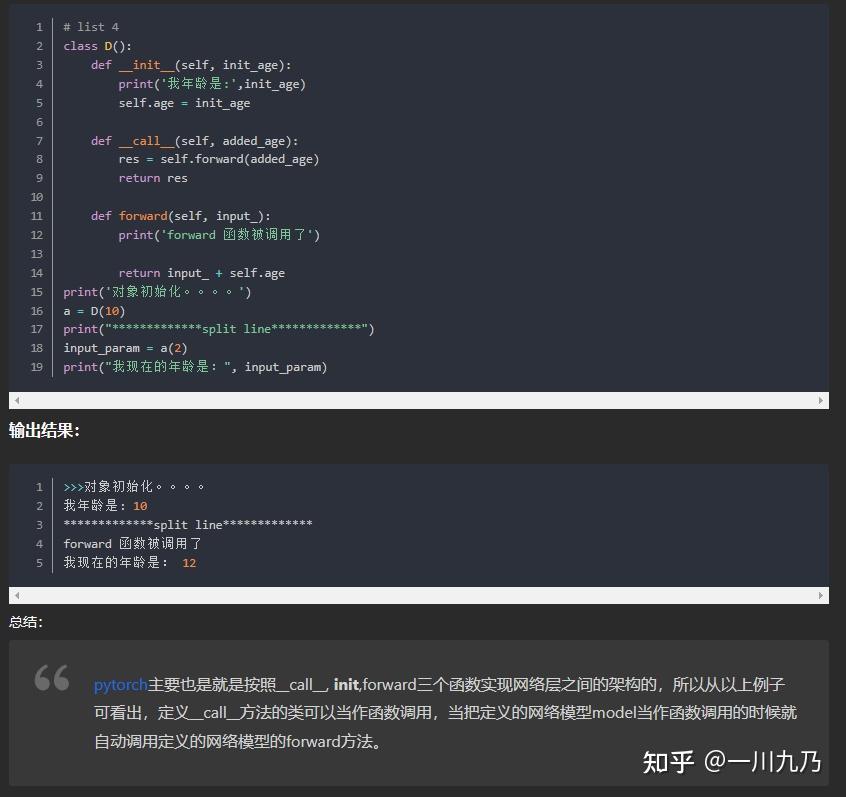 call&forward
这部分总结如下:forward是在__call__中调用的,而__call__函数是在类的对象使用'()'时被调用(如:a())。一般调用在类中定义的函数的方法是:a.func(),如果只是使用a(),那么这个操作就是在调用__call__这个内置方法。神经网络例中,out = net(image)实际上就是调用了net的__call__方法,net的__call__方法没有显式定义,那么就使用它的父类方法,也就是调用nn.Module的__call__方法,它调用了forward方法,又有,net类中定义了forward方法,所以使用重写的forward方法。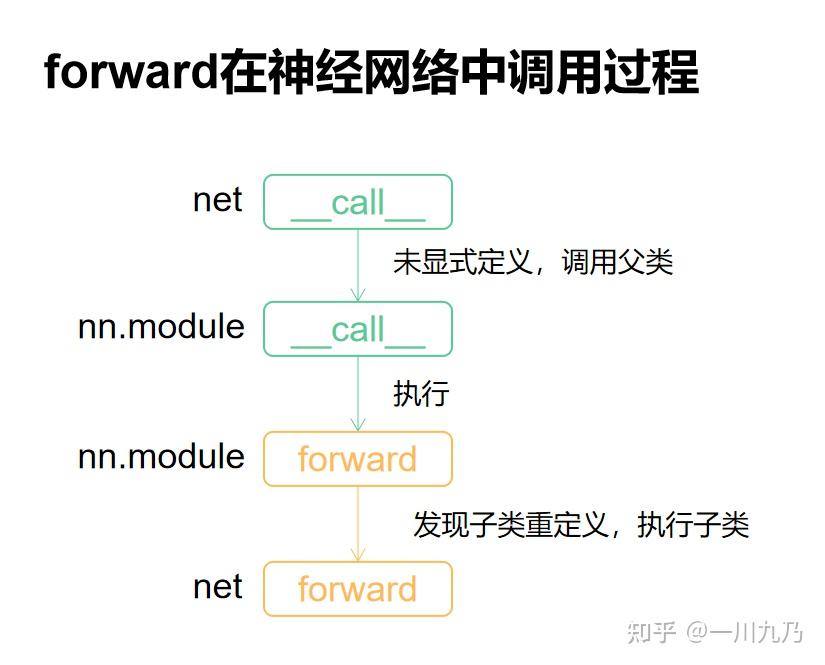 forward调用过程
剩下关于forward调用的细节参见以下链接:在PyTorch中,forward()是如何被调用的?
Encoder部分为transformers结构左侧的部分,其中内部分为N个EncoderLayer,每个EncoderLayer由两个sublayer组成:Multi-Head Attention和simple, position-wise fully connected feed-forward network,每一个sublayer外由sublayerConnection包装。Encoder的代码框架如下所示: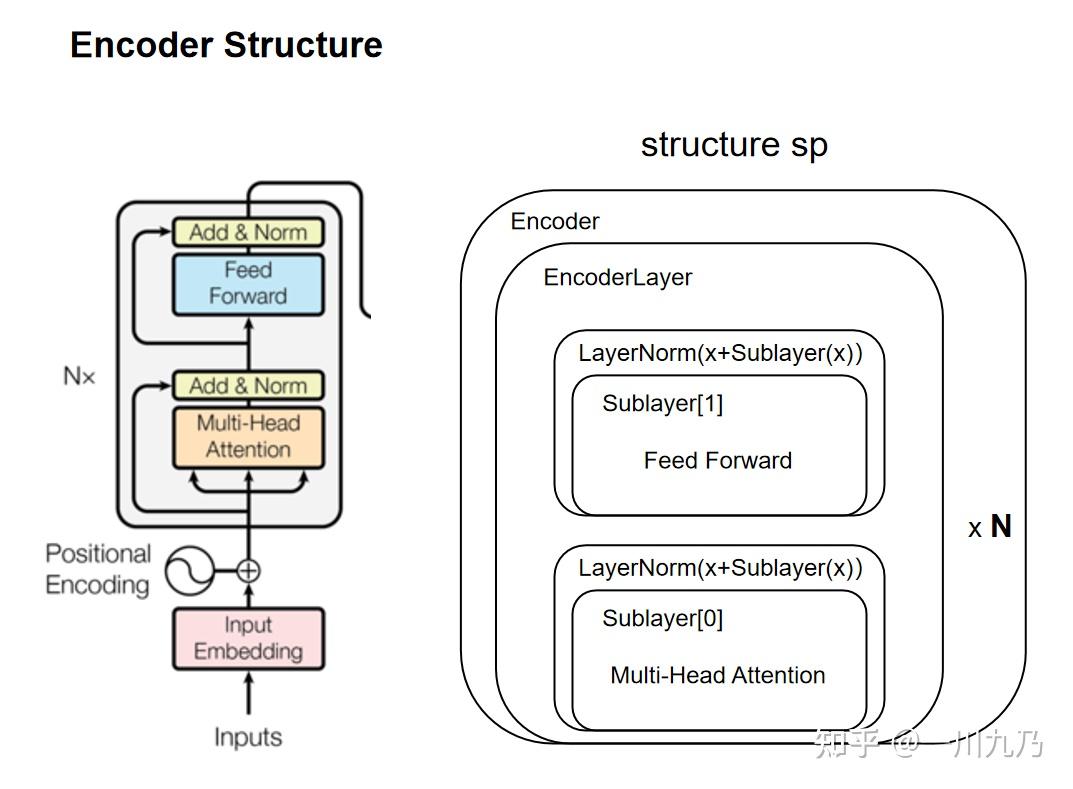 Encoder_structure
Encoder class所作的工作是深度拷贝N个EncoderLayer,并在x遍历完所有EncoderLayer后再进行一次LayerNorm。LayerNorm总共发生次数为次。
clone function 深度拷贝module至N个作为Encoder的layers成员,将input x依次输入进每一个layer中。这里使用了nn.ModuleList,ModuleList就像一个普通的Python的List,我们可以使用下标来访问它,它的好处是传入的ModuleList的所有Module都会注册的PyTorch里,这样Optimizer就能找到这里面的参数,从而能够用梯度下降更新这些参数。但是nn.ModuleList并不是Module(的子类),因此它没有forward等方法,我们通常把它放到某个Module里。
对最终的x进行LayerNorm处理,Layer Normalization通常用于 RNN 结构, 会将每一层神经元的输入都转成均值方差都一样的,这样可以加快收敛。
LN的公式如下:
其中g即,为增益(gain),b即,为偏置(bias),用来保证归一化操作不会破坏以前的信息。其中eps为很小的小数,防止除0。外层f为激活函数。
如上所述,EncoderLayer由两个sublayer构成:Multi-Head Attention和fully connected feed-forward network。
sublayer重用clone function来构建,其中sublayer[0]为Multi-Head Attention,sublayer[1]为fully connected feed-forward network。sublayer[0]和sublayer[1]之前存在数据的先后关系,故在EncoderLayer的forward function中先进行Multi-Head Attention再将处理结果提交至fully connected feed-forward network中最终作为整个结构的output。sublayer[0]有两个参数,第一个为tensor,第二个为callable,即SublayerConnection的第二个参数sublayer,该sublayer为callable,这里使用lambda隐藏了形参为x的一个函数命名,该函数以x为参数(mask为常量),调用self_attn函数。该形参x与第一个参数tensor x不是同一个x。
在encoder的structure sp中sublayer由sublayerConnection和sublayer具体实现两部分组成,其中sublayerConnection即为sp中的LayerNorm(x+Sublayer(x)),实现的是进行LayerNorm处理后的残差连接,残差连接通常用于解决多层网络训练的问题,可以让网络只关注当前差异的部分。
其中dropout机制作用为:在训练过程的前向传播中,让每个神经元以一定概率p处于不激活的状态。以达到减少过拟合的效果。是一种有助于训练的trick。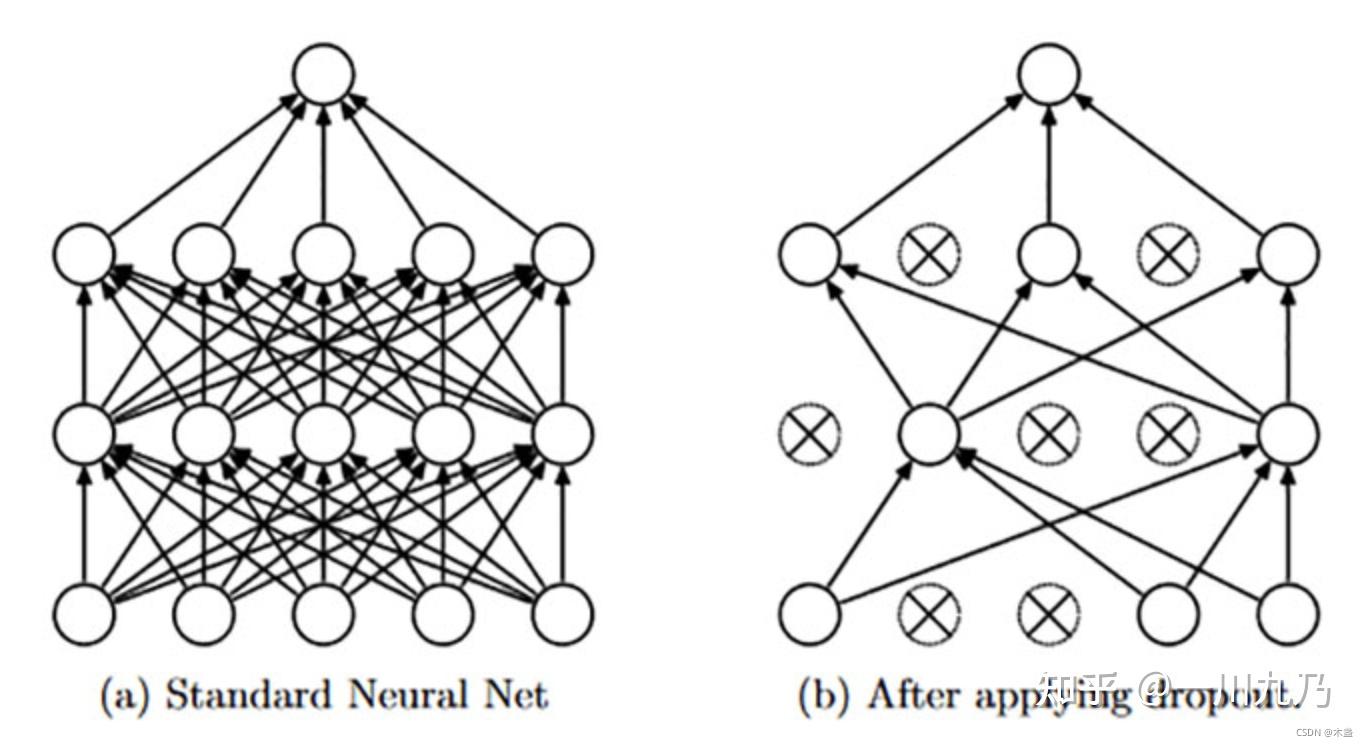 dropout
Multi-Head Attention和fully connected feed-forward network两个sublayer会在Decoder structure之后补充。
Decoder即结构中的右边部分,sp与encoder类似,DecoderLayer由三部分组成:与Encoder相同的两个sublayer和另外一个Masked Multi-Head Attention sublayer,其中EncoderLayer的结果作为memory存放在内存中,作为EncoderLayer的Multi-Head Attention的input参数。
Decoder结构和Encoder并无太大差异,仅仅是输入参数的不同。
添加mask有效保证了预测位置i时只依据位置i前面的信息而不提前预知后面位置的信息。如图所示,每一行代表当前mask,例如对于位置0,mask[0]只有自身信息有用,而越到后面可知信息越多,以此形成正三角的形状。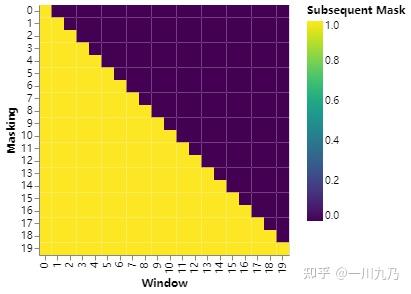 mask
triu function 返回上三角矩阵,再通过进行01反转,得到mask矩阵。
mask的构建还有其他方式,参考GPT note中的colab course,例如先将future position设为-inf再通过softmax归一化形成mask矩阵。mask仅作为自回归属性的实现,在cross-attention(即layer[1])那里便不需要加mask,因为此时需要KV也就是目标语言表示的所有信息。
偏移(offset)机制是为自回归提供ground_truth,也就是从起始符开始自回归预测。举例来说便是通过右移(shifted right)将给定squenece“I like bananas”变成“ I like”。
transformers所用的attention为"Scaled Dot-Product Attention",是得分函数之一(除此之外还有additive/concat等)其过程如下: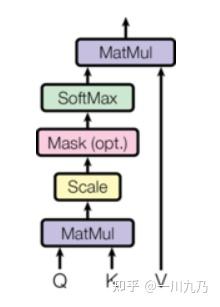 attention
Q stands for "a set of queries" while K stands for "a set of keys". 两者均为向量组成的矩阵,用来反映X之间各元素的相关性,key即键向量,作为某一input即单词的表示,query即查询向量,作为当前被编码词的表示。该相关性最后经过softmax归一化后通过与矩阵V相乘来将该相关性反映到X当中。过程的公式和代码如下: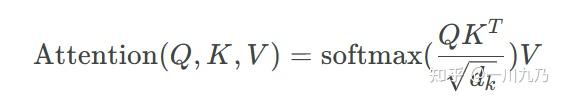
使用简单的例子,batch取2,head取1,第一个序列长度为3,第二个序列长度为4,则src-attn的src_mask维度为(2,1,1,4),表示为
就batch[0]而言,无论是序列中的哪一时刻,其mask都是[1, 1, 1, 0],第一时刻也可以attend to后面两个时刻;而对于self_attn的tgt_mask,因为要满足auto_regressive特性,t时刻只能获得[0 ~ t-1]时刻的信息,故该mask使用subsequent_mask function来定义,即下三角矩阵,表示为
之所以要标准化进行操作,是因为防止出现有的参数权重太大导致影响力过大,导致模型不稳定,稍微一动就会有大的变化;有些参数权重太小导致怎么改变都对最终结果影响甚微。
QKV三者均是关于input X的线性组合,即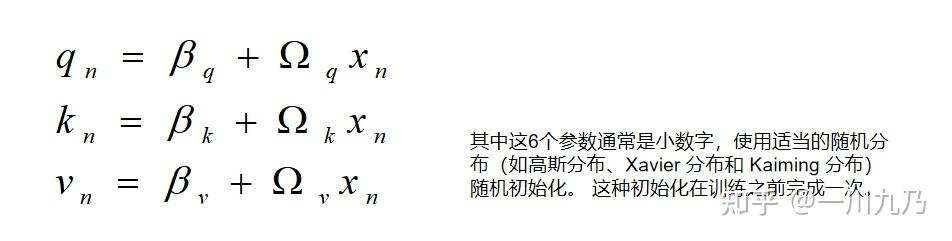
由于dot-product可以转化为矩阵计算来加速,Attention内部的计算顺序变得不可见了,而虽然矩阵能够化简计算,但影响了阅读者对attention机制的理解。Attention虽然在公式上已化约为三个矩阵的计算,但顺序和每一步的意义并不如计算表面那样。非常好的gif_attention原理
Attention的过程可以如上动态图表示,其中每一个input x对应着一个query、key和value,三者都是关于input x的一种表示,该表示的维度自定(图例中的维度为3),作为QKV矩阵的第二维度;QKV矩阵的第一维度为input的维度,意味着对于input x内每一个元素,都有3个参数来反映。NotesThe dimension of query and key must always be the same because of the dot product score function. However, the dimension of value may be different from query and key. The resulting output will consequently follow the dimension of value.qk的维度必须相同,而value可以不同,因为qk是通过点积计算的,计算出来永远是一个标量,而value是分别与标量相乘,所以其维度只反映在最终结果上,而不影响中间的计算。
如前所述,每一个input x对应着一个query、key和value,生成这三个指标的参数都是随机生成的,所以除了命名不同,它们本质上都是一样的。qkv计算的公式如上。
此处的score function为dot-product,即将某一个input的query和所有input的key点乘分别得到3个值,该值(或scaled后)反映得分情况,即图示蓝色块。
计算出score后将该值与value相乘,这一步一共发生3次,将这3个值最终相加在一起,得到的结果便是这一个query所得到的得分结果,即该input的注意力值。
综上即可知query意为查询,每一个input对其他input进行相关度查询(一个input即一个单词),key作为元素的键能够与query点乘来满足查询需要,最后将得分与每个input的value相乘累加。
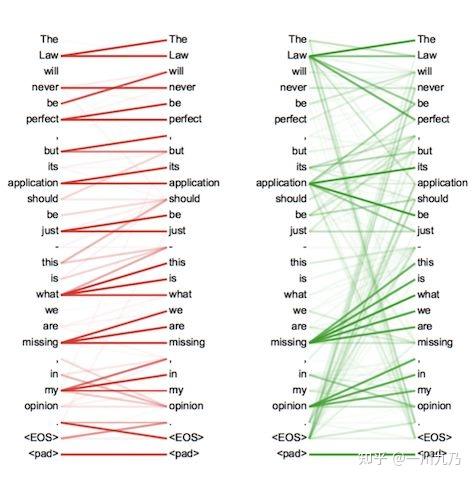
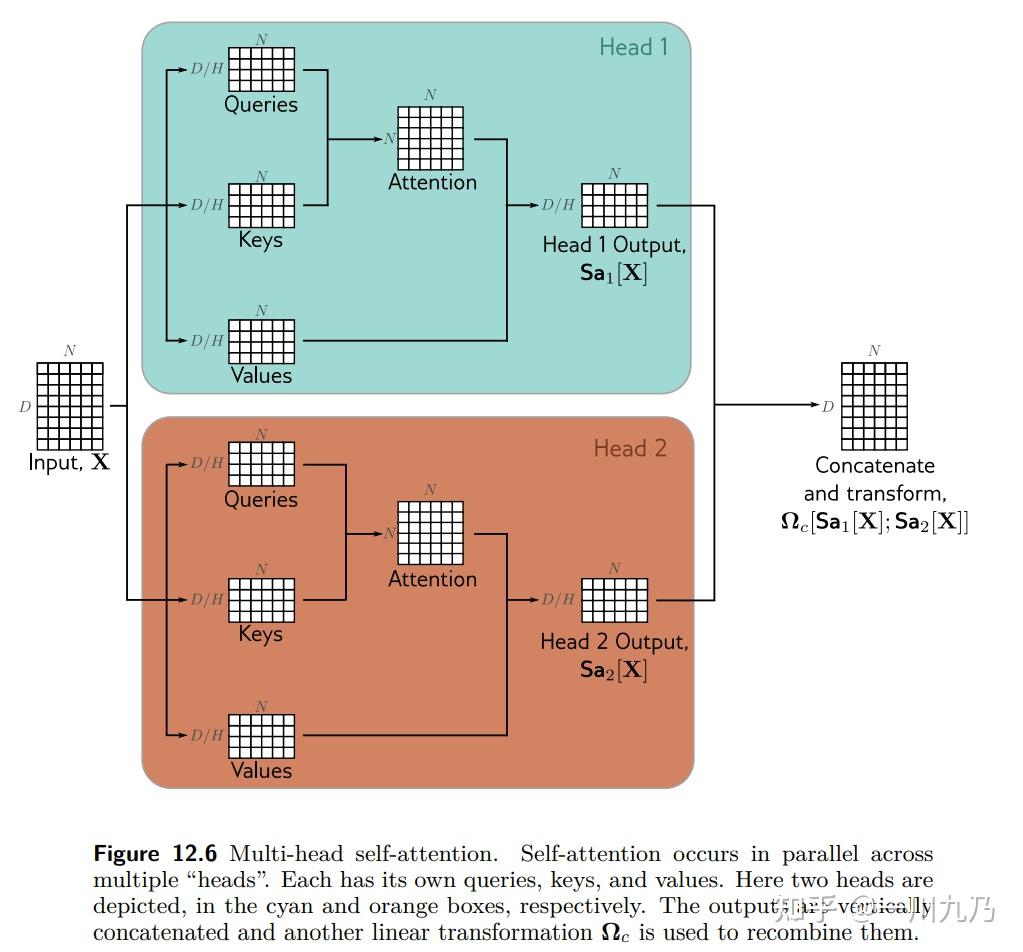
多头注意力机制使用多组QKV,可以理解为每一组QKV表示词与词之间的联系,多组即拥有了多种联系的表示能力,其1)扩展了模型专注于不同位置的能力,2)为注意力层提供了多个“表示子空间”(如中间图所示,)。右侧图即多头注意力机制,其中参数h即head的个数,也就是切割程度。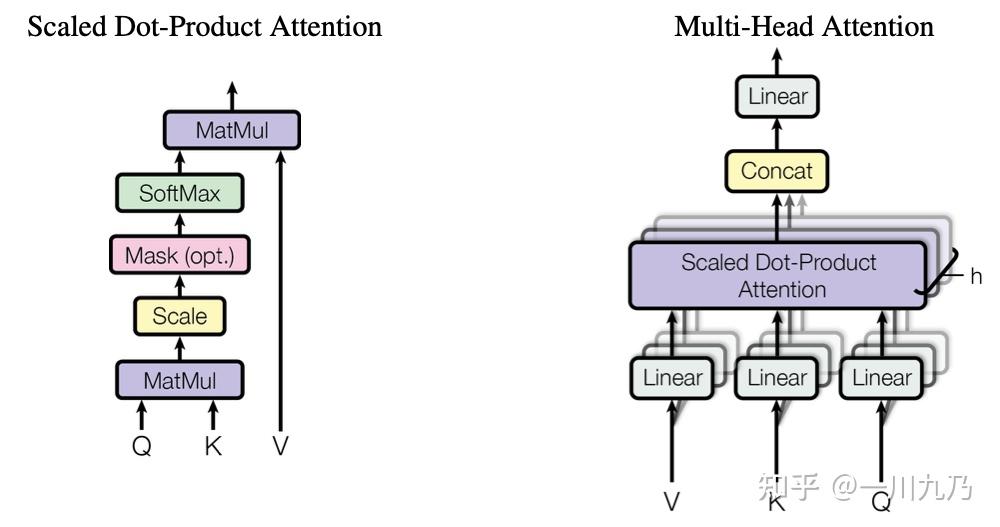 点积与多头
 multi-head
 multi-head
可以看出多头切割的是input x的维度,也就是x中的元素分多组小的QKV组合去处理。多头注意力机制代码如下:
zip(self.linears, (query, key, value))是把(self.linears[0],self.linears[1],self.linears[2])和(query, key, value)放到一起然后遍历。我们只看一个self.linears[0] (query)。根据构造函数的定义,self.linears[0]是一个(512, 512)的矩阵,而query是(batch, time, 512),相乘之后得到的新query还是512(d_model)维的向量,然后用view把它变成(batch, time, 8, 64)。然后transponse成(batch, 8,time,64),这是attention函数要求的shape。分别对应8个Head,每个Head的Query都是64维。x.transpose(1, 2)把x变成(batch, time, 8, 64),然后把它view成(batch, time, 512),其实就是把最后8个64维的向量拼接成512的向量。最后使用self.linears[-1]对x进行线性变换,self.linears[-1]是(512, 512)的,因此最终的输出还是(batch, time, 512)。我们最初构造了4个(512, 512)的矩阵,前3个用于对query,key和value进行变换,而最后一个对8个head拼接后的向量再做一次变换。
由transformers结构图可以看到,多头注意力机制在三处有使用,分别是encoder的layer[0]和decoder的layer[0]和layer[1],其中encoder的layer[0]的QKV来自同一地方,decoder的layer[0]同样如此,不过添加了mask机制来保留自回归性质;decoder的layer[1]也即“encoder-decoder attention” layers,Q来自于decoder的layer[0],而memory KV来自encoder的输出。
Position-wise Feed-Forward Networks,即基于位置的前馈网络。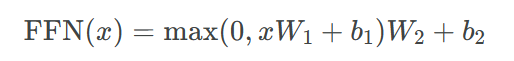
除了设置两组不同参数的layer,另一种方式是将其作为两个内核大小为1的卷积(或者认为是两次线性变换,如代码中所示)来处理。The dimensionality of input and output is d_model=512, and the inner-layer has dimensionality d_ff=2048.
Similarly to other sequence transduction models, we use learned embeddings to convert the input tokens and output tokens to vectors of dimension d_model.
one-hot vector相当于从词汇表中将给定文本中的这些词提取出来组成新的inputX的过程。
nn.Embedding(vocab, d_model)含义是生成vocab个d_model维度的词汇表,如下图所示: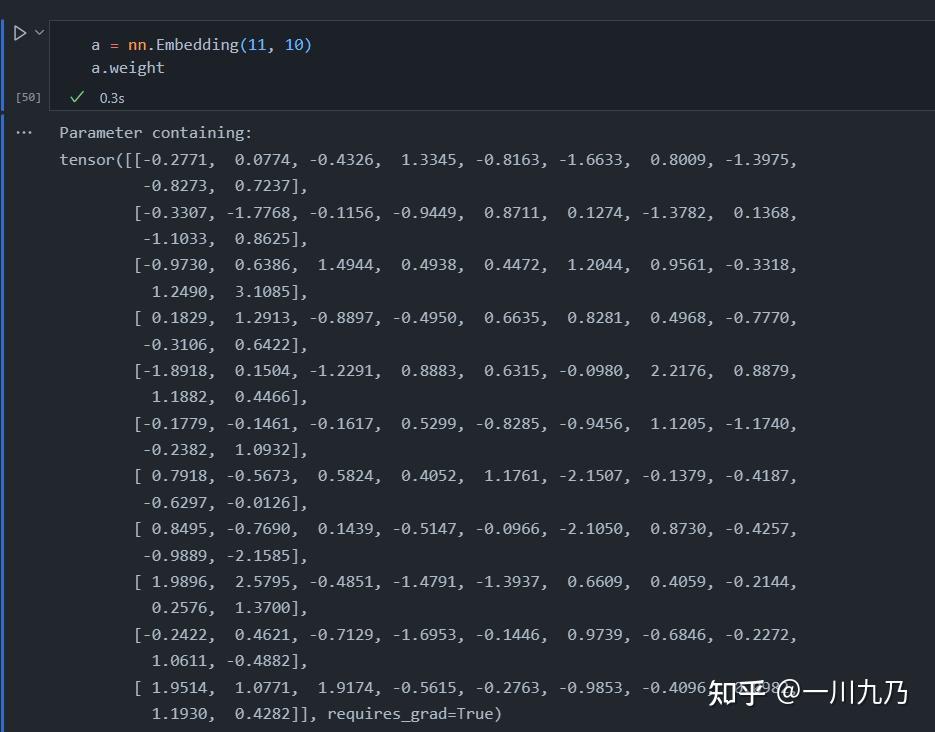 Embedding
函数型位置编码公式如下: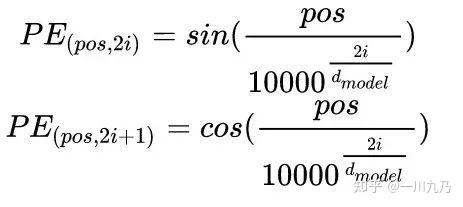 一种好的位置编码方案需要满足以下几条要求:1. 它能为每个时间步输出一个独一无二的编码;2. 不同长度的句子之间,任何两个时间步之间的距离应该保持一致;3. 模型应该能毫不费力地泛化到更长的句子。它的值应该是有界的;4. 它必须是确定性的。
使用函数型位置编码能够得知相对位置,如下图所示: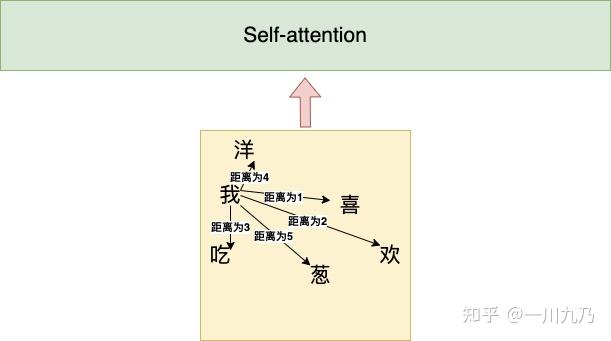 position_encoding
使用sin cos函数便来表示便可以得出相对位置信息,结论是两个token距离越远位置量PE的乘积结果越小。使用该方式的缺点在于只知道距离信息而没有方向信息,谁在前谁在后是无从得知的,如下公式所示。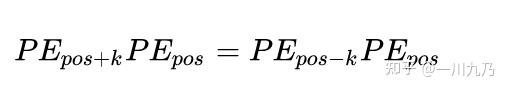 使用加法来将位置信息添加进input x中是因为位置信息在很大的embedding dimension中只占了很小一部分,这一小部分也很容易被transformers分离出来。位置信息之所以不因为进入更高层而损失是通过残余连接来保证的,残余连接也是为了当model变得deeper后loss accuracy达到饱和,通过添加该机制能够更好的进行训练。positional encoding还有其他方式,如直接调用transformer.wpe
4. 在GPT中,作者对position embedding矩阵进行随机初始化,并让模型自己学习,而不是采用正弦余弦函数进行计算。
make_model function implementation
整个encoder-decoder运行过程如下所示:非常好的gif_transformer_decoding_1
第一部分是编码器,将input单词进行词嵌入和位置编码后生成的向量输入进encoder结构中,encoder结构通过两层sublayers——multi-head attention和feed-forward为主的sublayer——处理后输出词的表示(即Key键向量)和词的价值(即Value值向量),组成注意力向量集。
得到注意力向量集后,即作为decoder的KV来使用,此时decoder的输入进行了整体右移(Shifted Right),第一个输入input为起始符,通过起始符词嵌入和位置编码后进入decoder结构预测出output第一个单词。
迭代decoder的过程,直到输出为终止符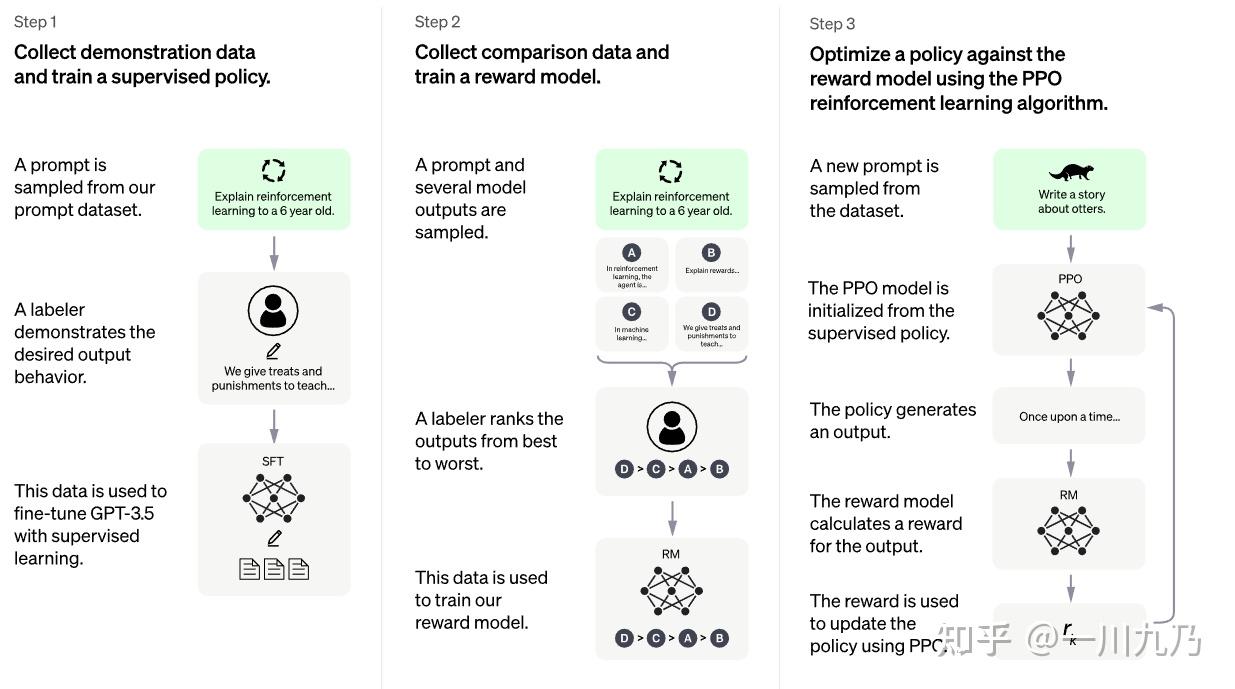 chatGPT_finetuning
通过监督学习,强化学习等方式进行微调,微调将model的功能从document completer变成针对具体任务。