2015年老谷歌账号-谷歌邮箱
DESCRIPTION / 资源参数说明
自从 ChatGPT 横空出世之后,人工智能和大语言模型在最近几年可以说是泛科技圈最火的东西,没有之一。这篇文章的动机是需要向同事们全面介绍一下大语言模型(以下简称大模型),但是我查了很久,现在基本没有可以用简单的语言,从技术人的角度,带领初学者全面了解大模型领域的文章。因此,我的目的是能通过这篇文章带领感兴趣的读者、有人工智能基础知识的初学者,以广度为主,全方位了解大模型的方方面面。由于是广度为主,加上为了不拉长篇幅,所以对于一些技术细节,本文将不会涉及。
另外,在本文中不会涉及到更细节的部分,而是会给出大量的扩展阅读文章,这些文章都会很好的解释章节的主题。这里额外推荐一篇中文版大模型综述论文,来自人大高瓴。
让我们开始吧!
自“人工智能”这个概念在达特茅斯会议中提出之后,人们对“智能”就开始了不懈的追求。而“智能”,就是认识世界和改造世界的能力。
如何实现“智能”呢?
以人类为例,要认识并改造世界,我们必须具备感知环境、认知推理和与环境互动的能力。在这三种基本能力中,认知推理是智能的核心环节。因此,实现智能的一个关键就在于增强认知推理能力。认知推理需要能表达和处理复杂的信息,我们需要一种能表达世界的方法。这时,我们自然而然会想到使用一种直观的东西:语言。
语言是人类对现实世界的一种符号化表达,从具体到抽象。通过语言,我们可以精确地表达和共享关于世界的理解。这种能力使语言成为连接人类智能与机器智能、世界和个体之间的桥梁,让机器能通过理解和生成语言来更好地服务于人类,理解我们的指令与需求。因此,目前实现认知推理,甚至实现通用人工智能 (Artificial General Intelligence, AGI) 的一种主流路径,就是构建强大的语言处理能力。 关于 AGI 的实现方式和人工智能的范式,又是个宏大的科学哲学话题了,这里就不展开一堆哲学黑话了,有兴趣的读者可以自行了解,如符号主义、连接主义、知识表示等等。
那么,如何构建强大的语言处理能力呢?
人工智能早早就有了一个子方向:自然语言处理 (Natural Language Processing, NLP) 。随着它的发展,语言处理方式有千千万万,但在如今的深度学习时代,目前最为有效的模型之一,就是基于神经网络的语言模型。相比于上个时代的精心设计模型结构来增强模型,现在一种更有效的方法是通过扩大模型规模来增强它的能力,至于名字 则朴实无华的叫做:大语言模型(Large Language Model, LLM)。 本文的“大模型”,都指的是大语言模型。与之类似的,真·大模型 (Foundation Model, FM) 或者翻译成“基础模型”,则是一种更广泛的概念,一般指的是在多个任务、多种数据类型或多个领域中都可以重复使用的预训练大模型。这些模型不仅限于处理语言,还可以包括图像、音频等其他类型的数据,如 CLIP,BERT 等等。
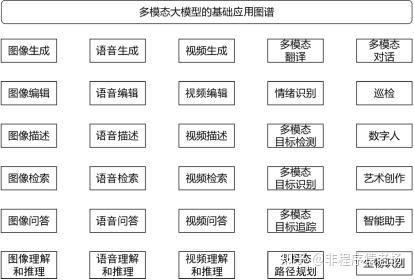
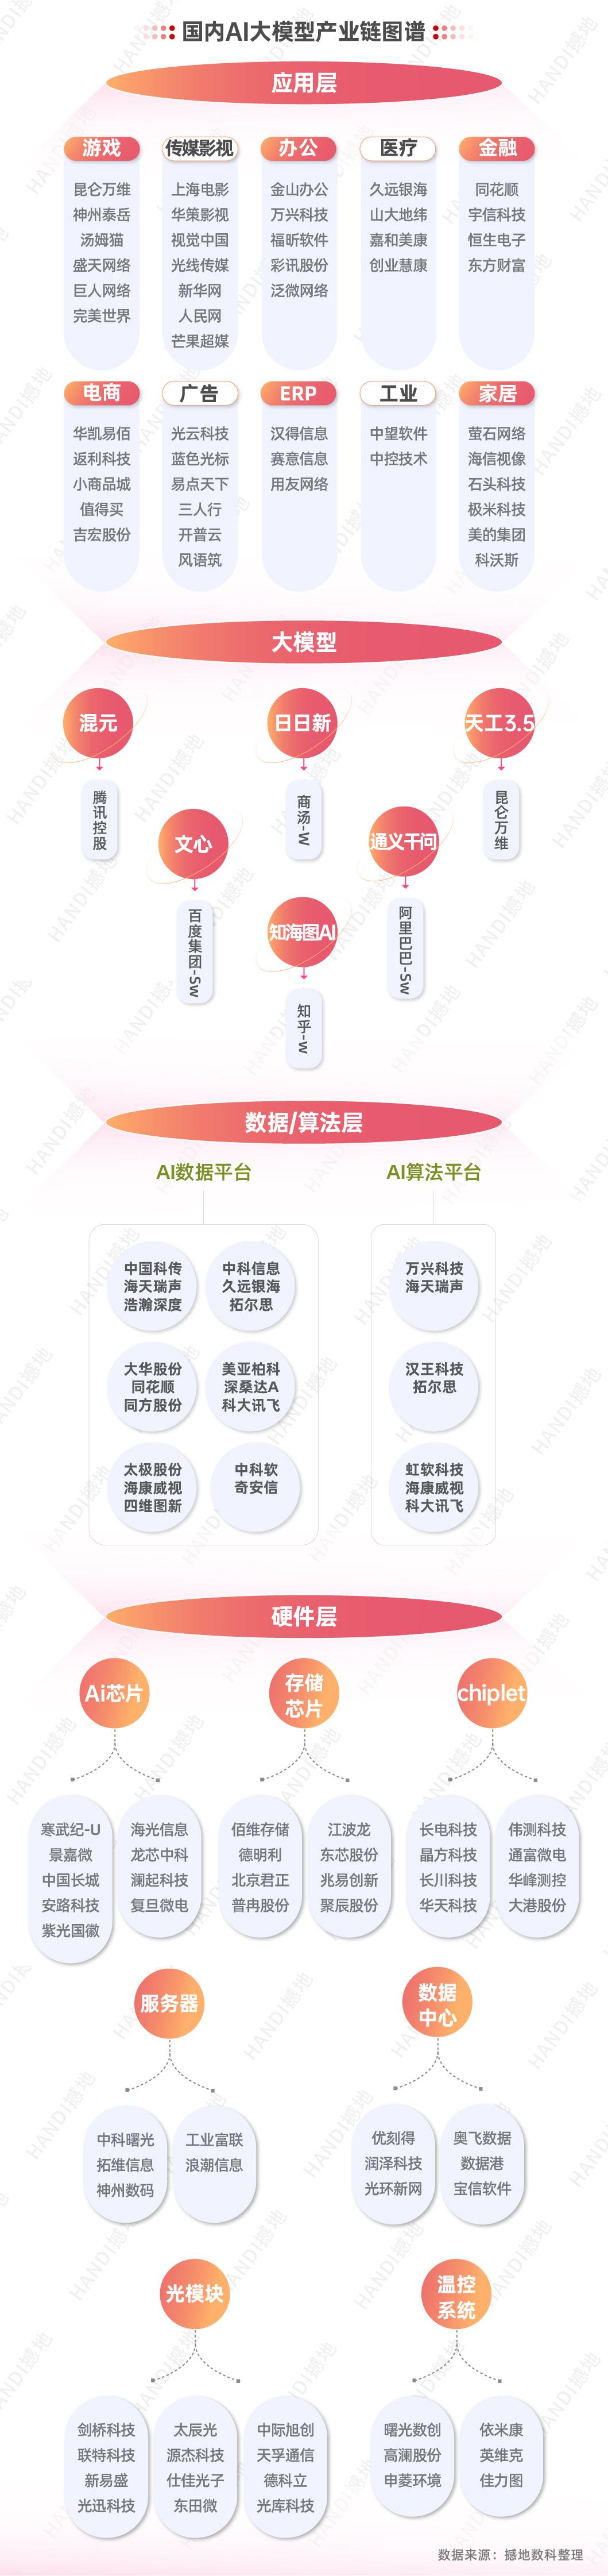
由于语言几乎可以表达万事万物,大语言模型也近乎可以可以影响到各个领域。大模型成功地压缩了人类对于整个世界的认知,让我们看到了实现通用人工智能的路径。可以说,在互联网世界,有人的地方,大模型就可以上,在一定程度上代替人的工作。这里就不对应用方向进行列举了,因为几乎是无穷无尽,可以说,只要是你能想到的东西或者是工作,都可以加上大模型,进行智能升级。
不过,由于大模型的算力要求高、输出稳定性待加强,所以目前的实际商业落地情况其实并不是特别好。 扩展阅读:2023大模型落地应用案例集、万字长文,AI大模型的应用实践总结、一文讲清大模型AI应用架构、解码国内AI大模型产业链现状
大语言模型,一种比较学术的定义是:具有大规模参数和复杂计算结构的机器学习语言模型。别看表述得有点难度,其实我们可以从字面上理解,无非就是大号的语言模型。所以,要搞懂大语言模型是什么,我们先得来搞清楚语言模型是什么。
语言模型就像是一个理解语言规则和用法的智能系统。它能够分析文本数据,并学习其中的语言模式,例如词汇的使用方式、语法结构和句子的连贯性。这种模型可以用来预测一个句子中下一个可能的词语是什么,或者根据给定的文本生成新的文本。你可能听说过,大模型其实就是“预测下一个词”。本质一点地说,就是:这个模型,对于任意的词序列,能够计算出这个序列是“一句人话”的概率。
当我们说语言模型可以计算词序列的概率时,意味着它能够评估一个词序列在语言使用中的自然程度或者说合理程度。比如,对于一个给定的词序列,语言模型会告诉我们这个序列在真实语言中出现的可能性有多大。
也许对于统计学不太熟悉的读者还是不太能搞清楚,这里举个例子:现在,假设我们有一个句子的部分序列,例如:"我喜欢吃"。我们想要预测下一个可能的词是什么。这时,我们可以利用语言模型给出的概率信息。语言模型告诉我们,“我喜欢吃”这个序列后面接上“苹果”的概率是0.3,“香蕉”的概率是0.2,“西瓜”的概率是0.1,等等。然后,通过比较这些概率,我们可以选择概率最高的词作为下一个词的预测结果。在这个例子中,由于“苹果”的概率最高,我们就可以预测下一个词可能是“苹果”。
所以,语言模型的计算概率能力为我们提供了一种方法,基于前面词语的上下文信息来预测下一个可能的词。鉴于本文以广度为主,这里就不展开更多概念和细节了。
目前,最广泛采用的是基于神经网络的语言模型,在这个神经网络中,每个词或者句子都会被表示为一个向量(详见附录一章),然后将它们送入神经网络进行训练。同时,现在我们说的“大模型”,绝大部分是基于一种叫做的模型架构。
这一节将会给你简单直观地介绍一下架构和需要的基础概念。
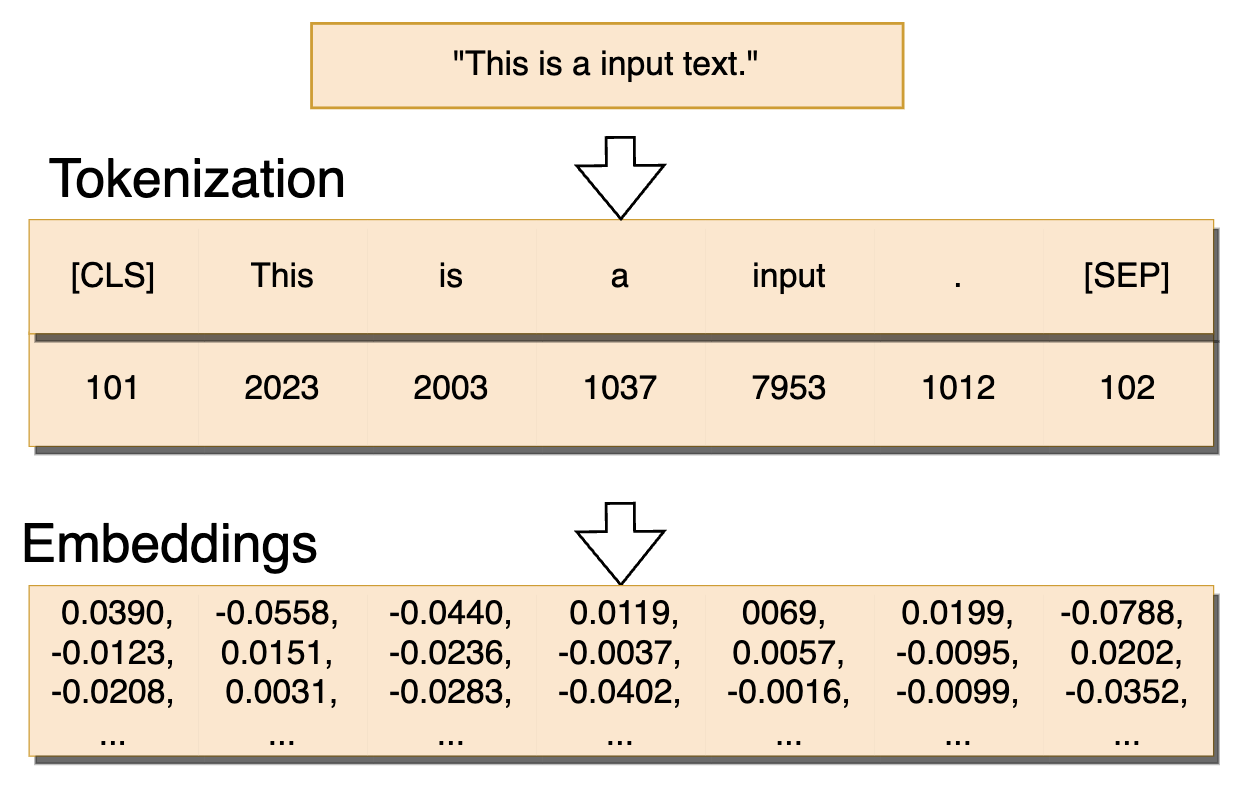
为了处理语言,我们需要先解决如何在模型中表示语言的问题。与我们使用文字或语音来表达语言类似,计算机处理语言时也需将其转化为特定的表现形式。
鉴于计算机基本上是处理数字的机器,我们可以通过数字来表示语言。在线性代数中,一个点的位置可以用一组数字,即来描述。同理,我们可以将文本的“含义”抽象为在某个含义空间中的“位置”,并通过将文本转换为数字向量的形式,使其成为计算机可以理解的数据,这种转换过程称为。例如,表达式可以被转化为向量,在数学上这可以视为一个五维空间中的点。通过这种嵌入方法,每个单词都映射到向量空间的一个点上,从而使得语义相似的单词在该空间中彼此更接近。
另外,如同我们可以计算向量间的距离来反映他们之间的关系一样,既然我们把语言的含义转换为了向量,我们也可以通过计算转换之后向量间的距离,来计算文本间的语义相似度,如计算余弦相似度 (Cosine Similarity)。 扩展阅读:从词到数:Tokenizer与Embedding串讲、大模型基础组件 - Tokenizer、一文读懂Embedding的概念,以及它和深度学习的关系、文本嵌入(Text Embeddings)
在 NLP 任务中,我们在 Embedding 过程中,希望加入更多语义关系的信息以提高模型的理解能力,注意力机制在这一过程中起到了关键作用。字面意思,这种机制如同人的注意力一样,通过动态地选择重要的信息片段,以便模型能够更好地聚焦于任务相关的特征,从而提高了处理语言数据的效率和效果。
注意力机制的基本思想是在输入序列中为每个元素分配一个权重,这些权重表示了各元素对于当前任务的重要性。这使得模型不再将所有输入信息等同对待,而是能够根据每个元素的实际贡献来调整其重视程度。在实践中,这通常是通过一个可学习的权重函数来实现的,该函数根据输入元素间的相互作用来动态调整权重分配。
Attention 机制可以说是现代 NLP 乃至所有 AI 子方向的基础知识了,这里推荐读者去详细了解一下。 扩展阅读:注意力机制综述(图解完整版附代码)
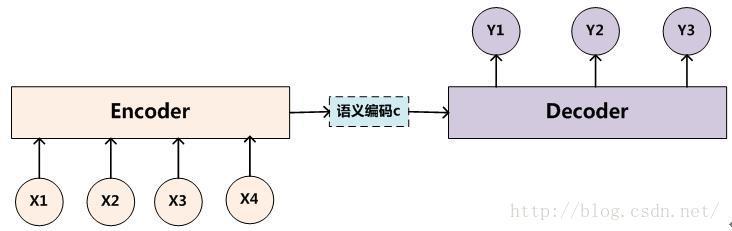 编解码器示意图
经典的 Transformer 是由编码器和解码器这两部分组成的,我们先来了解一下最基本的编解码器结构。如图所示,编码器负责将输入序列编码为连续表示,而解码器则根据编码器的输出和先前生成的部分序列来生成输出序列;换个通俗易懂的说法就是:编码器负责将输入序列编码成某个附带有额外信息(例如语义关系、注意力等等)的向量,解码器负责将这个向量解码为输出。
目前的主流大模型,多是 Decoder-Only 的架构,在文本生成任务 (Natural Language Generation, NLG) 上表现更好,效率更高;传统的 Encoder-Decoder 架构会在文本理解任务 (Natural Language Understanding, NLU)上表现更好。

作为现代大模型的核心,Transformer 出现在 2017 年的论文 Attention Is All You Need 里面,旨在改善之前依赖于复杂递归神经网络(RNN)和卷积神经网络(CNN)的语言模型的性能和效率。Transformer 完全依赖于注意力机制来处理序列的数据,这一点与之前的模型架构不同,它不使用任何递归或卷积层。
Transformer 架构的核心是它的自注意力(Self-Attention)机制,这使得模型能够同时关注输入序列中的所有位置,并计算每个位置的表示,这对于理解和生成语言尤为重要。此外,Transformer 还包括多头注意力(Multi-Head Attention),这允许模型在不同的表示子空间中并行地学习信息。
我们可以简单的把左边一大块当做编码器,右边的一大块当做解码器,通过简单堆叠这些重复的模块,就可以实现模型的增大。
使用伪代码解释生成过程的话,就是:
扩展阅读:Transformer模型详解(图解最完整版)、一文了解Transformer全貌(图解Transformer)
其实,现在我们也不清楚神经网络和大模型为什么能有效,但是关于模型的内部基本原理,我们可以搞清楚。关于技术原理,强烈推荐阅读这篇技术博客,我无法比这篇文章写得更好了:Large language models, explained with a minimum of math and jargon;还可以阅读一个中文翻译版本。内部运行过程的可视化可以参考这个网站,作者搞得非常直观酷炫。
现在,我们明白了大模型的基本概念。那么,如果想要让模型变得强大,可以使用什么方法呢?难道简单的增大模型就可以吗?
答案是:没错。
在模型增大的过程中,会出现一种叫做“涌现”的现象:当模型的规模(包括计算量、模型参数或数据集大小)达到一定程度时,某些能力会“突然”出现拐点,性能肉眼可见地骤然提升,这种能力的提升并不是简单的线性增长,而是质的飞跃。例如,大模型可能突然具备了多步算术、词义消歧、逻辑推导、概念组合、上下文理解等能力,这些都是传统小模型所难以实现的。
“涌现”理论的主要奠基人约翰霍兰德出版的《涌现:从混沌到秩序》中描述了这么一种现象:就如蚂蚁社群、神经网络、免疫系统、互联网乃至世界经济。但凡一个过程的整体行为远比构成它的部分复杂,均可称为“涌现”现象,举个例子。通常说来,“涌现”指一个系统中个体间预设的简单互动行为所造就的无法预知的复杂样态的现象。
简而言之,小个体组成整体,整体属性却不同于个体累加之和。涌现是由简生繁的过程,它无处不在。 扩展阅读:大语言模型的涌现能力:现象与解释
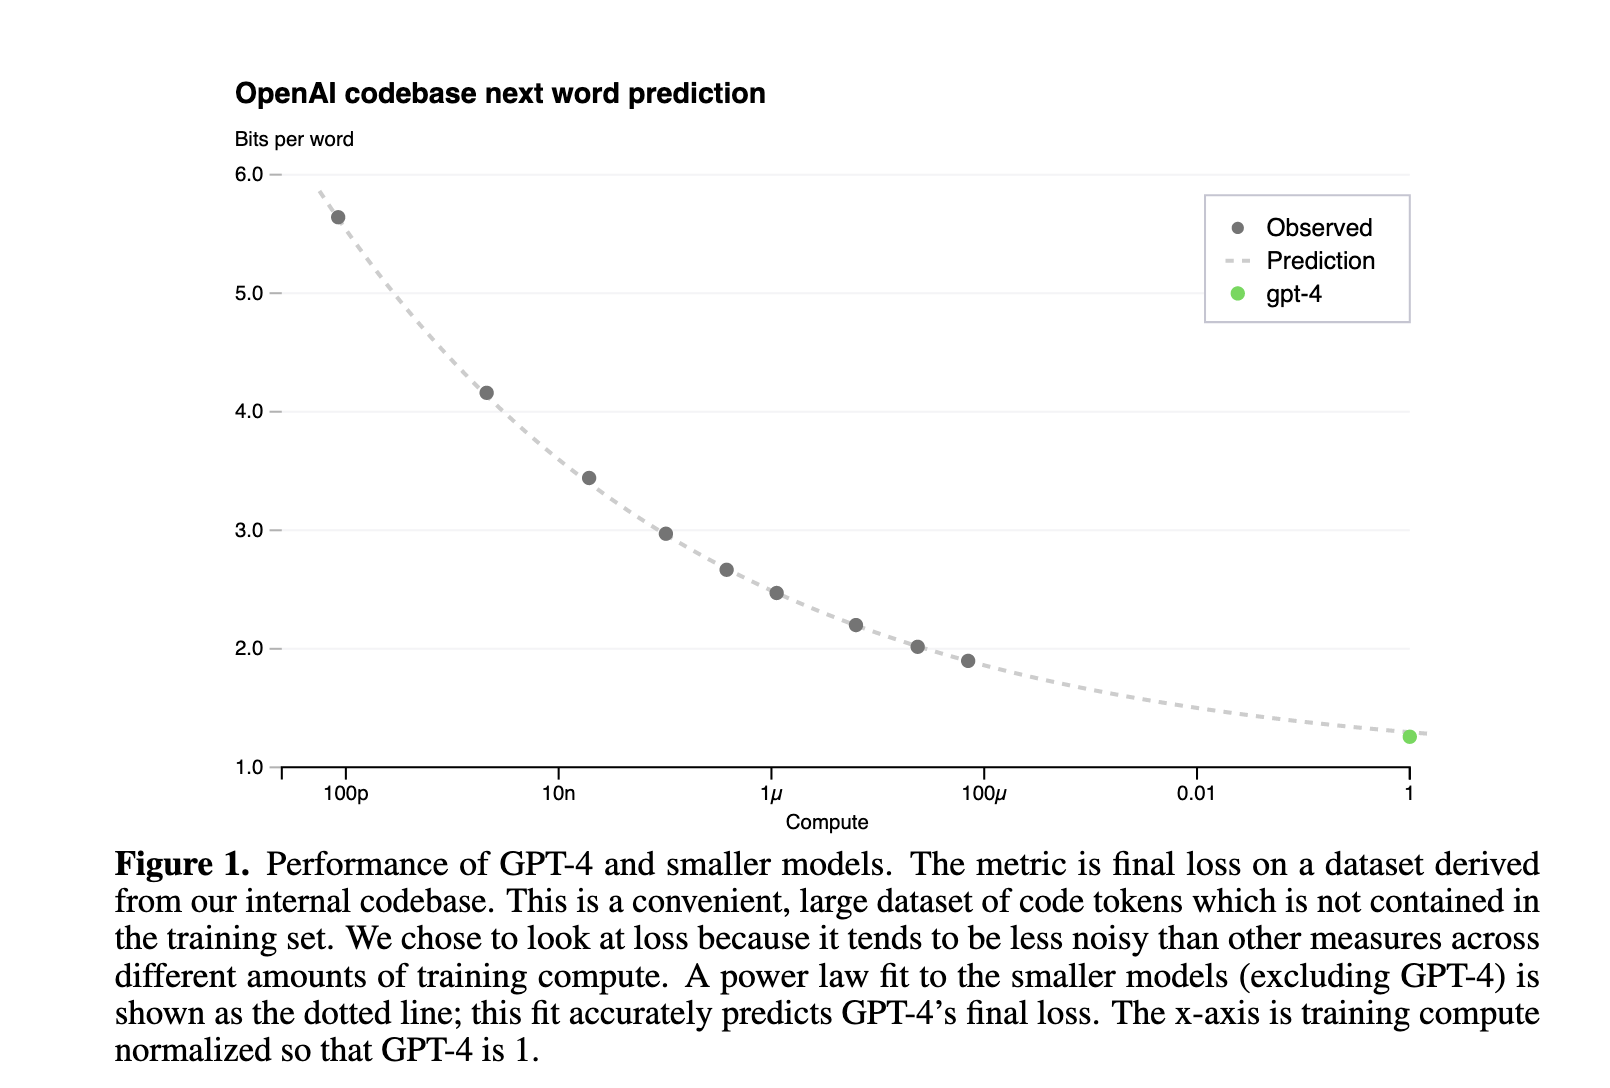
既然提到了涌现现象,我们就不得不探讨模型的性能与其规模之间的关系。
在 2020 年,OpenAI 发布了一篇极具影响力的论文:Scaling Laws for Neural Language Models,详细阐述了计算量(Flops)、模型参数量以及数据规模(token 数)之间的相互关系,论文指出,模型的性能随着参数数量的增加而提升。同时,我们也能够估算出在特定的资源限制条件下,所需的模型规模和数据处理量,以达到我们预期的性能目标。
因此,针对开头提出的疑问,我们有了明确的回答:为什么模型需要变得更大?原因在于规模的增加直接关联到模型性能的提升。在面对越来越复杂的任务时,更大的模型能够更有效地处理信息,提取特征,从而实现更为精准的预测和决策。这也是当前人工智能研究中不断追求更大模型的重要动力之一。
除此之外,还有 ChinChilla 等缩放定律,更多信息可以参阅维基百科:Neural scaling law - Wikipedia 扩展阅读:解析大模型中的Scaling Law
随着新发布的模型越来越大,我们不禁想问:多大才算大?
在过去几年中,关于“大模型”的定义已经不断发生变化。在早期,数百万或几千万个参数的模型就被认为是“大模型”。但现在,由于模型的参数量和计算复杂度都在不断增加,因此数亿甚至数十亿个参数的模型也变得更加常见,事实上,现在的大模型参数量都是以“B (Billion,十亿)” 为单位的,我们看到某个模型是多少多少 B,实际上就是指有几十亿的参数。因此,目前认为大模型的标准也在不断变化。可以想象,一年以后,回过头看今天开源社区玩得热火朝天的 7B 和 13B 模型,也会被称作为小模型被未来更大的模型淹没的。
在 Scaling Laws 中,我们知道,模型越大,算力要求会平方地增长。所以,多大才算大呢?这要取决于我们当前所处时代的算力了。 扩展阅读:多大的参数才算大模型--关于“大”模型的一些思考
在清楚大模型是什么、能干什么之后,这节,我们来聊聊怎么构建大模型。
由于开源精神以及互联网的易传播性,所以在今天,你能轻松访问到很多公开的大模型资源。在这小节,我将给你介绍现有的一些不错的大模型资源。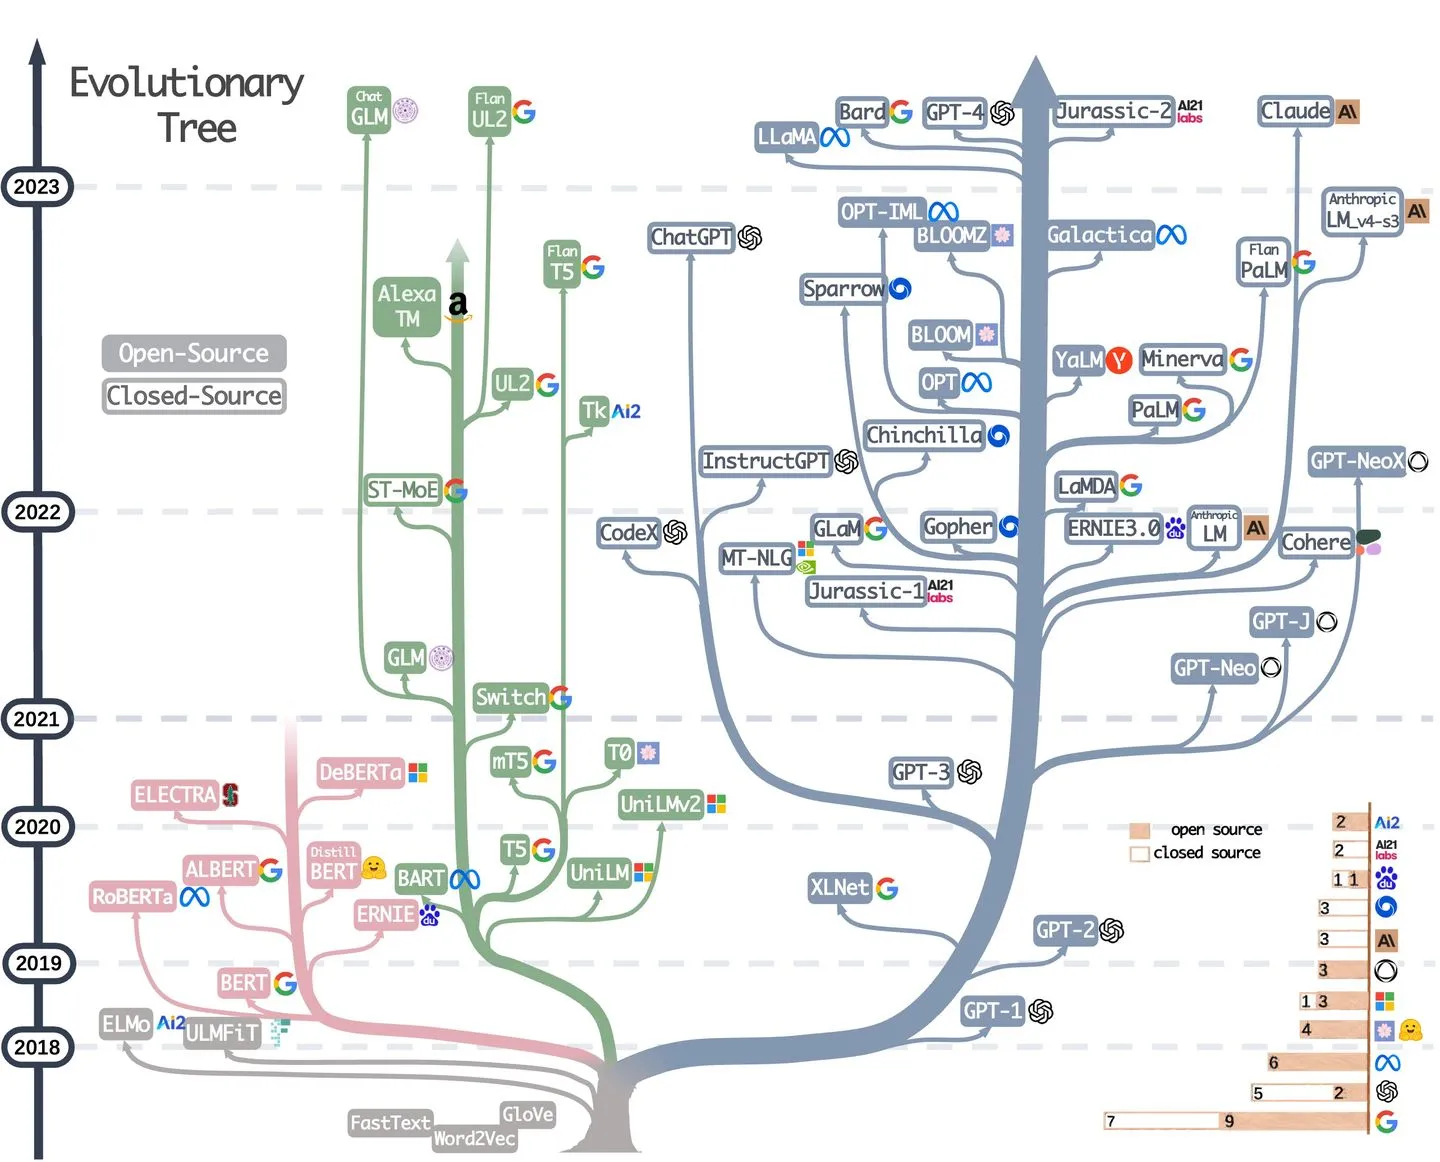
构建大模型的基础技术是公开的,可实践的,所以由于最近算力的迅速发展,加上资金的大量涌入,全球各地的科技公司和研究机构纷纷投身构建自己的人工智能模型。这种趋势催生了一个新时代——“百模大战”,各个模型不仅在规模上竞争,更在性能和智能化程度上展开了激烈的对决。国内如清华的 ChatGLM系列、阿里的通义千问(Qwen)系列、百度的文心一言和 Ernie 系列、零一万物的 Yi 系列、百川智能的 Baichuan 系列等等,国外如 OpenAI 的 xGPT 系列、Google 的Bard 系列、DeepMind 的 Alpha系列、Facebook 的 LLaMA系列等都是这场“百模大战”中的重要参与者。这些模型在多个维度上进行了创新和优化,不仅在语言模型、知识整合能力上有所突破,也在特定任务的应用效率和精度上达到了前所未有的水平。其中的开源大模型,我们可以从下面的开源模型平台中获取并使用。 扩展阅读:HqWu-HITCS/Awesome-Chinese-LLM: 整理开源的中文大语言模型
评测榜单
为了评估和比较不同人工智能模型的性能,目前有很多基于不同评价规则的评测榜单,这些榜单公开展示了各模型在特定任务上的表现和排名,可以参考参考。需要注意的是,现在有很多模型为了数据好看,进行了很多“调优技巧”,导致在各种评分上可能很高,但是实际的体验并不好,所以,大伙还需要辩证看待。OpenCompass司南 - 评测榜单 提供了一个详尽的排行榜,展示了各大模型在多种语言处理任务上的性能表现。The Big Benchmarks Collection - a open-llm-leaderboard Collection (huggingface.co) 由 Hugging Face 主办,收集了广泛的语言模型基准测试。
开源模型平台
开源模型平台为开发者提供了便捷的接口来下载和部署各种先进的人工智能模型,同时也支持社区的贡献和模型的迭代更新。Hugging Face – The AI community building the future. 是一个领先的开源模型和数据集库,集中了来自全球的AI模型和数据集,促进了AI技术的民主化。
Hugging Face 国内镜像站模型库首页 · 魔搭社区 (modelscope.cn) 你可以认为是国内版本的 huggingface,提供了丰富的模型选择,支持多种计算框架和应用场景。 飞桨AI Studio星河社区 - 人工智能学习与实训社区 (baidu.com) 是由百度推出的一个集教学、训练和交流于一体的AI社区,旨在提供全面的AI开发和学习环境。
目前有一些知名的大模型库,可以很方便的调用各种模型,以及进行模型的改造和研究。以下是一些广泛使用的大模型库:Hugging Face Transformers: 一个非常流行的开源库,提供了超过100种预训练模型,用于自然语言处理(NLP)任务,如文本分类、信息抽取、问答、翻译等。 TensorFlow Hub: 由 TensorFlow 提供的一个库,集成了大量的机器学习模型,特别是在图像处理、视频分析和自然语言处理方面。 PyTorch Hub: PyTorch 的模型库,提供了各种领域的预训练模型,包括视觉、文本、音频和生成模型。 ONNX Model Zoo: 提供了一系列使用开放神经网络交换格式(ONNX)的预训练模型,支持不同的机器学习框架和平台。 PaddlePaddle Model Hub: 由百度支持的深度学习平台,提供了广泛的模型库,尤其是在中文处理和工业级应用上有很多优化和特定的模型。 Apache MXNet Model Zoo: Apache MXNet 提供的模型库,含有多种在计算机视觉、语音识别和自然语言处理等领域的预训练模型。
由于从 0 开始训练一个可用的大模型所需的数据量、算力都非常高,一般人基本搞不来,所以这里就不进行详细介绍了。事实上,更主流的应用范式是从预训练模型微调。 扩展阅读:从零开始训练大模型、从0开始预训练1.4b中文大模型实践
预训练模型是机器学习领域的一种重要方法,其核心思想是在大量未标注的数据上进行初步训练(即预训练),以学习数据的通用特征和规律。这些学习到的特征随后可以应用于各种特定任务,通过在少量标注数据上进行进一步的精调(微调),使得模型能够快速适应并提高在这些特定任务上的表现。具体来说,预训练模型首先在一个原始任务上进行训练,这个原始任务通常设计得让模型能够学习到数据的广泛和普遍的特征。
目前,由于大模型的训练对算力和数据要求都非常高,所以大家的主流应用方式是使用有资源的大厂或者实验室训练好的通用模型,根据自己的需求或者使用自己的数据进行 Prompt 工程(后面会聊到),或是使用各种方法进行微调。事实上,对于一般的小公司或者个人来说,要想全新开发训练自己的大模型几乎不可能,要知道像 ChatGPT 这样的大模型,一次训练的成本就在上千亿美元。
NLP 和大模型方向,目前的一个重要范式就是:一般领域数据的大规模预训练,对特定任务或领域的微调(Fine-Tune)。
在大模型的应用中,如果是一个难度不高的,或是不很“奇奇怪怪”的任务,我们完全可以发挥模型的通用性,直接进行 Prompt 工程,即可得到很不错的结果。只有在数据集不多,或是垂类应用的特定领域,才需要进行模型内部参数的改变微调。
接下来,介绍几种主流的模型微调方法。
SFT (Supervised Fine-Tuning),监督微调,是指在源数据集上预训练一个神经网络模型,即源模型。然后创建一个新的神经网络模型,即目标模型。目标模型复制了源模型上除了输出层外的所有模型设计及其参数。这些模型参数包含了源数据集上学习到的知识,且这些知识同样适用于目标数据集。源模型的输出层与源数据集的标签紧密相关,因此在目标模型中不予采用。微调时,为目标模型添加一个输出大小为目标数据集类别个数的输出层,并随机初始化该层的模型参数。在目标数据集上训练目标模型时,将从头训练到输出层,其余层的参数都基于源模型的参数微调得到。
目前,由于算力资源问题,普通组织在垂类领域的工程应用上一般不会采用 SFT 方法。
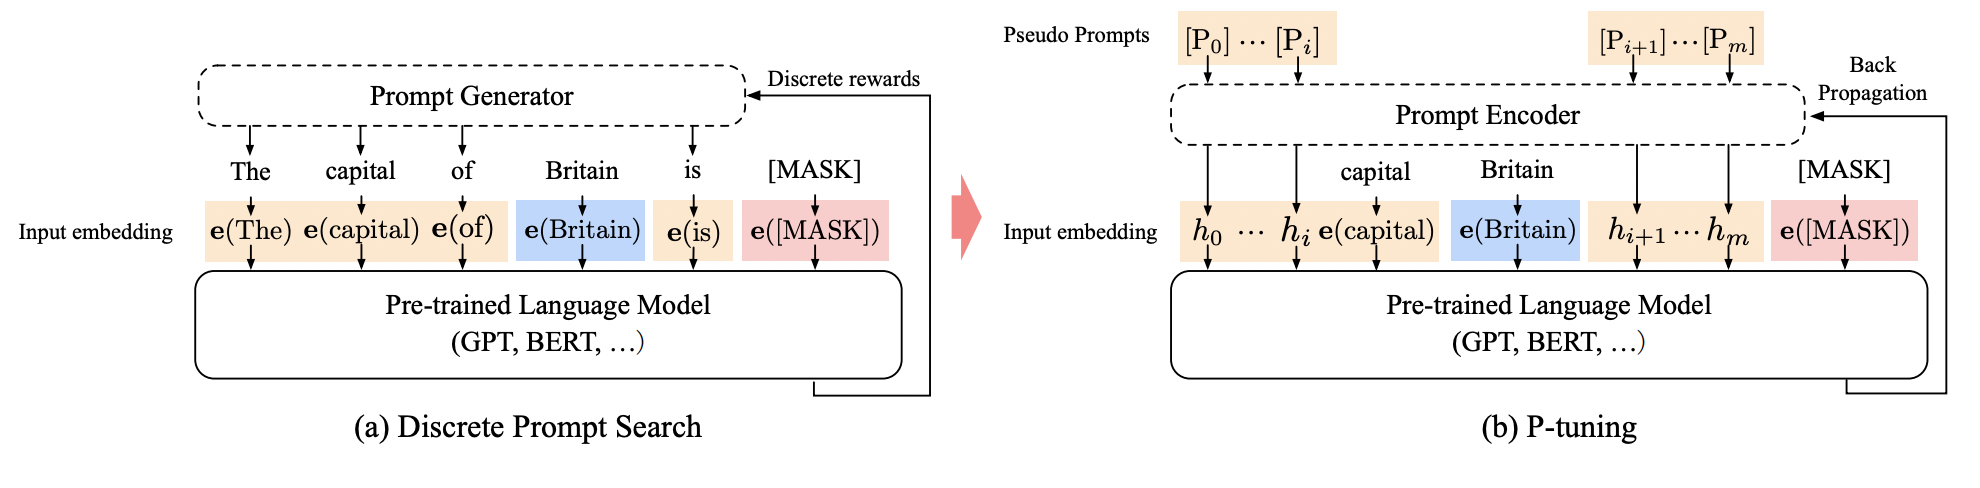
P-Tuning v2: Prompt Tuning Can Be Comparable to Fine-tuning Universally Across Scales and Tasks 是一种优化的自然语言理解(NLU)任务的提示调整方法。这种方法的目的是通过尽可能少地改变模型参数来调整大型语言模型,使其既高效又强大,特别适用于小型或中型模型以及复杂的任务,如序列标记。
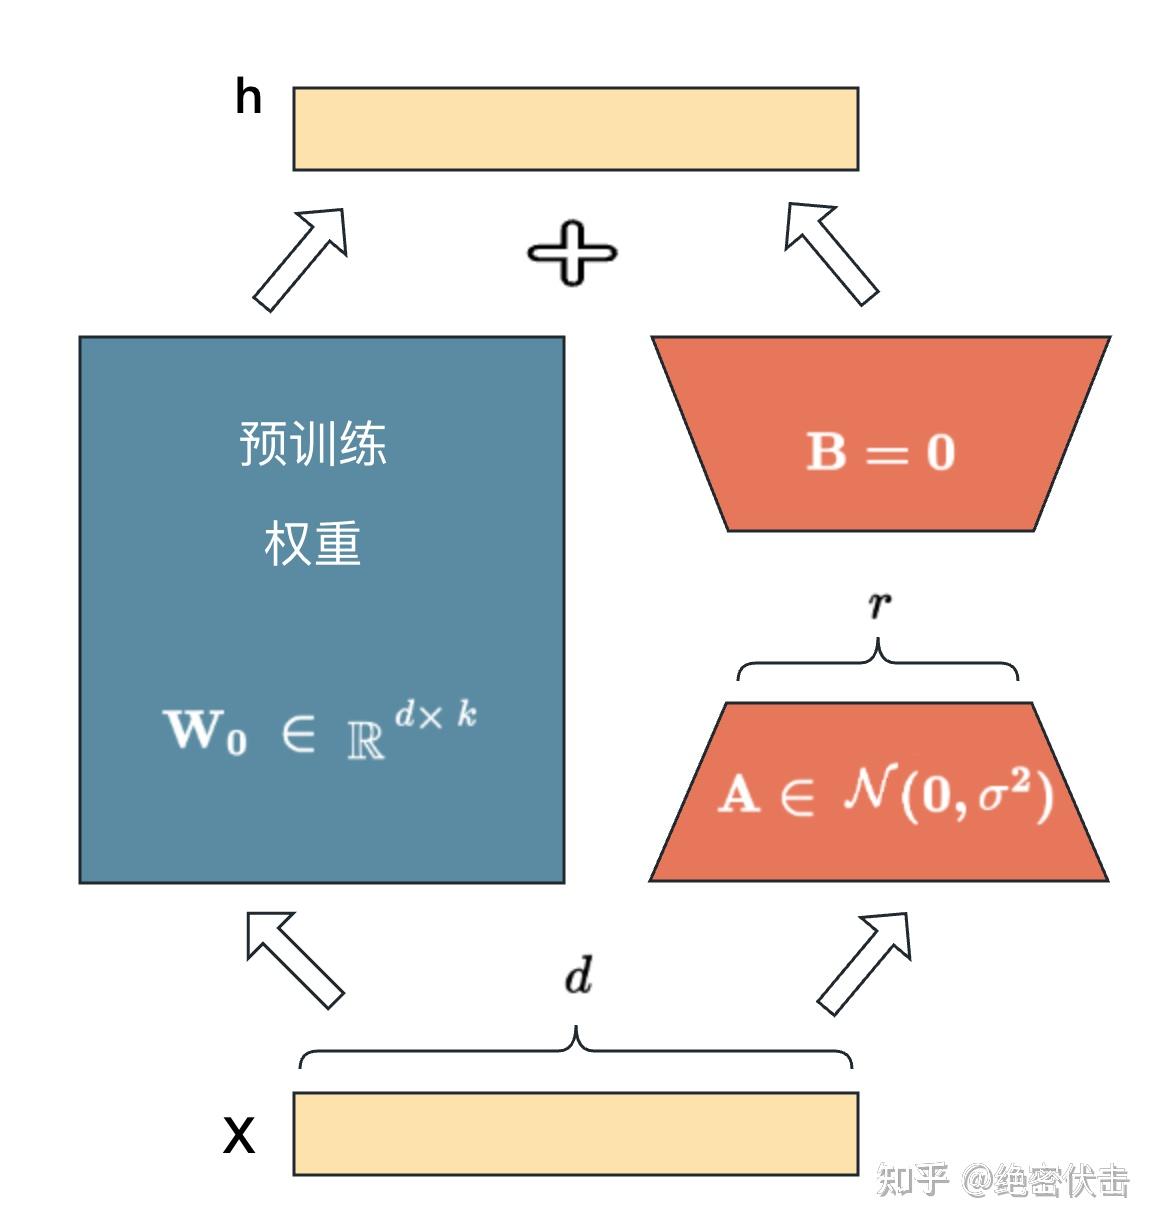
LoRA: Low-Rank Adaptation of Large Language Models 是一种目前使用最广泛的微调技术。它允许我们通过优化适应过程中密集层变化的秩分解矩阵,来间接训练神经网络中的一些密集层,同时保持预先训练的权重不变。它所需调整的参数量较全参数微调(Fine-Tuning)显著降低,参数量和现有高效参数微调方法持平或更低;性能优于其它参数高效微调方法,和全参数微调基本持平甚至更高。
现在,出现了很多 LoRA 的变体,如adaLoRA、QLoRA 等等,应用也都非常广泛,读者可以自行了解。 扩展阅读:LORA:大模型轻量级微调、LORA和它的基本原理
目前,大模型可能会产生不精确、误导甚至有害的文本,稳定性还有待提高。因此,采用一种叫做对齐 (Alignment) 的技术 来确保这些模型表现出与人类价值观一致的行为,变得至关重要。通往 AGI 的道路上,AI Alignment (AI 对齐) 是安全打开 “潘多拉魔盒” 的黄金密钥。
对齐是大模型中非常重要的一环,它的起源可以追溯到推动人工智能革命的最初雄心:创造能够像人类一样思考和行动的机器,甚至超越人类的愿望。如果我们成功地创造了如此强大的机器,如何确保它们的行为符合我们的最大利益,而不是对我们不利?这个悬而未决的问题不仅激起了人们的好奇心,还突显了在塑造人工智能未来时所承担的深刻责任。
现在的主流有RLHF(Reinforcement Learning from Human Feedback)这种基于强化学习的、基于监督式微调的对齐、上下文内对齐等等方法。 扩展阅读:一文带你了解大模型(LLMs)对齐、大语言模型的对齐:综述、四万字详解AI对齐
加速模型的训练和推理,一直是一个热门方向。这一小节,我们来聊聊加速和优化的事儿。
要加速模型的速度,首先想到的就是改变模型内部结构,从而实现变快。现在也确实有很多技术可以实现这个目的,例如将原本的 attention 机制变为 flash-attention、Sparse Attention,将 transformer 变成 reformer 等等。
由于训练加速方法很多,这里简单列举一下一些主流的方法:混合精度训练 :FP16+FP32 或 BF16+FP32; DeepSpeed分布式训练 :ZeRO-1、ZeRO-2、ZeRO-3; 各种加速框架:例如 Megatron 等; Torch FSDP + CPU Offloading ; 3D并行 ; INT8模型量化 :对称/非对称量化、量化感知训练; 参数有效性学习(Parameter-Efficient Learning) :LoRA、Adapter、BitFit、P-tuning; 混合专家训练(Mixed-of Experts,MoE) :每次只对部分参数进行训练; 梯度累积(Gradient Accumulation) :时间换空间 梯度检查点(Gradient checkpointing) :时间换空间
量化
模型量化 (Quantization),即以较低的推理精度损失将连续取值(或者大量可能的离散值)的浮点型模型权重或流经模型的张量数据定点近似(通常为 int8)为有限多个(或较少的)离散值的过程。它是以更少位数的数据类型用于近似表示 32 位有限范围浮点型数据的过程,而模型的输入输出依然是浮点型。这样,就可显著减小模型尺寸,降低存储需求,从而适应边缘设备的空间限制。这种压缩不仅便于模型的在线升级和传输,还能减少内存消耗和提高推理速度,因为整型运算通常比浮点型运算快。此外,模型压缩量化有助于减少设备的能耗并支持运行速度较慢的低功耗8位微处理器,在多种应用场景下非常有价值。
目前工程上的主流量化方法有 TensorRT、ONNX、各种库自带的方法等。
剪枝
剪枝 (Pruning),是一种用于减少是参数数量和计算量的技术。它通过识别和去除在训练过程中对模型性能影响较小的参数或连接,从而实现模型的精简和加速。通常,模型剪枝可以分为两种类型:结构化剪枝(Structured Pruning)、非结构化剪枝(Unstructured Pruning)。
知识蒸馏
知识蒸馏是一种机器学习模型压缩方法,它用于将大型模型(教师模型)的知识迁移到较小的模型(学生模型)中。它通过将知识从复杂的模型(称为教师模型)转移到更简单的模型(称为学生模型)来实现这一点。KD背后的核心思想是将教师模型的综合知识转化为更精简、更有效的表示。
模型训练完,部署后进行工作的输出过程叫做推理。在最后的推理加速环节是最直接影响用户体验的环节。在算力较低的端侧,我们一般使用模型压缩技术来减少算力需求,而在算力较高的服务器上,我们通常会使用分布式推理、KV-Cache 等等技术。 扩展阅读:进我的收藏夹吃灰吧:大模型加速超全指南来了
HPC (High Performance Computing) 高性能计算方向一直是非常火热的方向,有兴趣的读者可以深入了解这个领域,会涉及到计算机的方方面面,非常有趣。
既然原始的大模型只能处理单向文字的输入输出,那么它是怎么和我们进行固定格式的良好互动的呢?又是怎么实现看图听歌看视频,甚至是观测空间等等功能的呢?这就要聊到如何扩展它的能力了。
Prompt 工程(Prompt Engineering),或者说提示工程,字面意思,就是关注提示词(Prompt)的开发和优化,可以利用大模型的通用性,更好地将大模型用于各种特定场景和研究领域。早在2020年,OpenAI 就在论文 Language Models are Few-Shot Learners 中提出了如何设计使用 prompt 来提升大模型的推理能力。
这是目前最主流最简单的大模型应用范式。因为大模型的通用性非常好,所以对于简单的应用,只需要通过告诉模型怎么做,就可以完成特定的任务。事实上。你看到的很多非常酷的,收获了很多投资的大模型应用,很可能仅仅是套了层 Prompt 的壳子,例如角色扮演、自动写文等等,大多都是模型根据特定 Prompt,直接遵循指令输出的东西。
掌握了提示工程相关技能将有助于用户更好地了解大型语言模型的能力和局限性。研究人员可利用提示工程来提升大语言模型处理复杂任务场景的能力,如问答和算术推理能力。开发人员可通过提示工程设计、研发强大的工程技术,实现和大语言模型或其他生态工具的高效接轨。
提示工程不仅仅是关于设计和研发提示词。它包含了与大语言模型交互和研发的各种技能和技术。提示工程在实现和大语言模型交互、对接,以及理解大语言模型能力方面都起着重要作用。用户可以通过提示工程来提高大语言模型的安全性,也可以赋能大语言模型,比如借助专业领域知识和外部工具来增强大语言模型能力。 扩展阅读:提示工程指南 | Prompt Engineering Guide
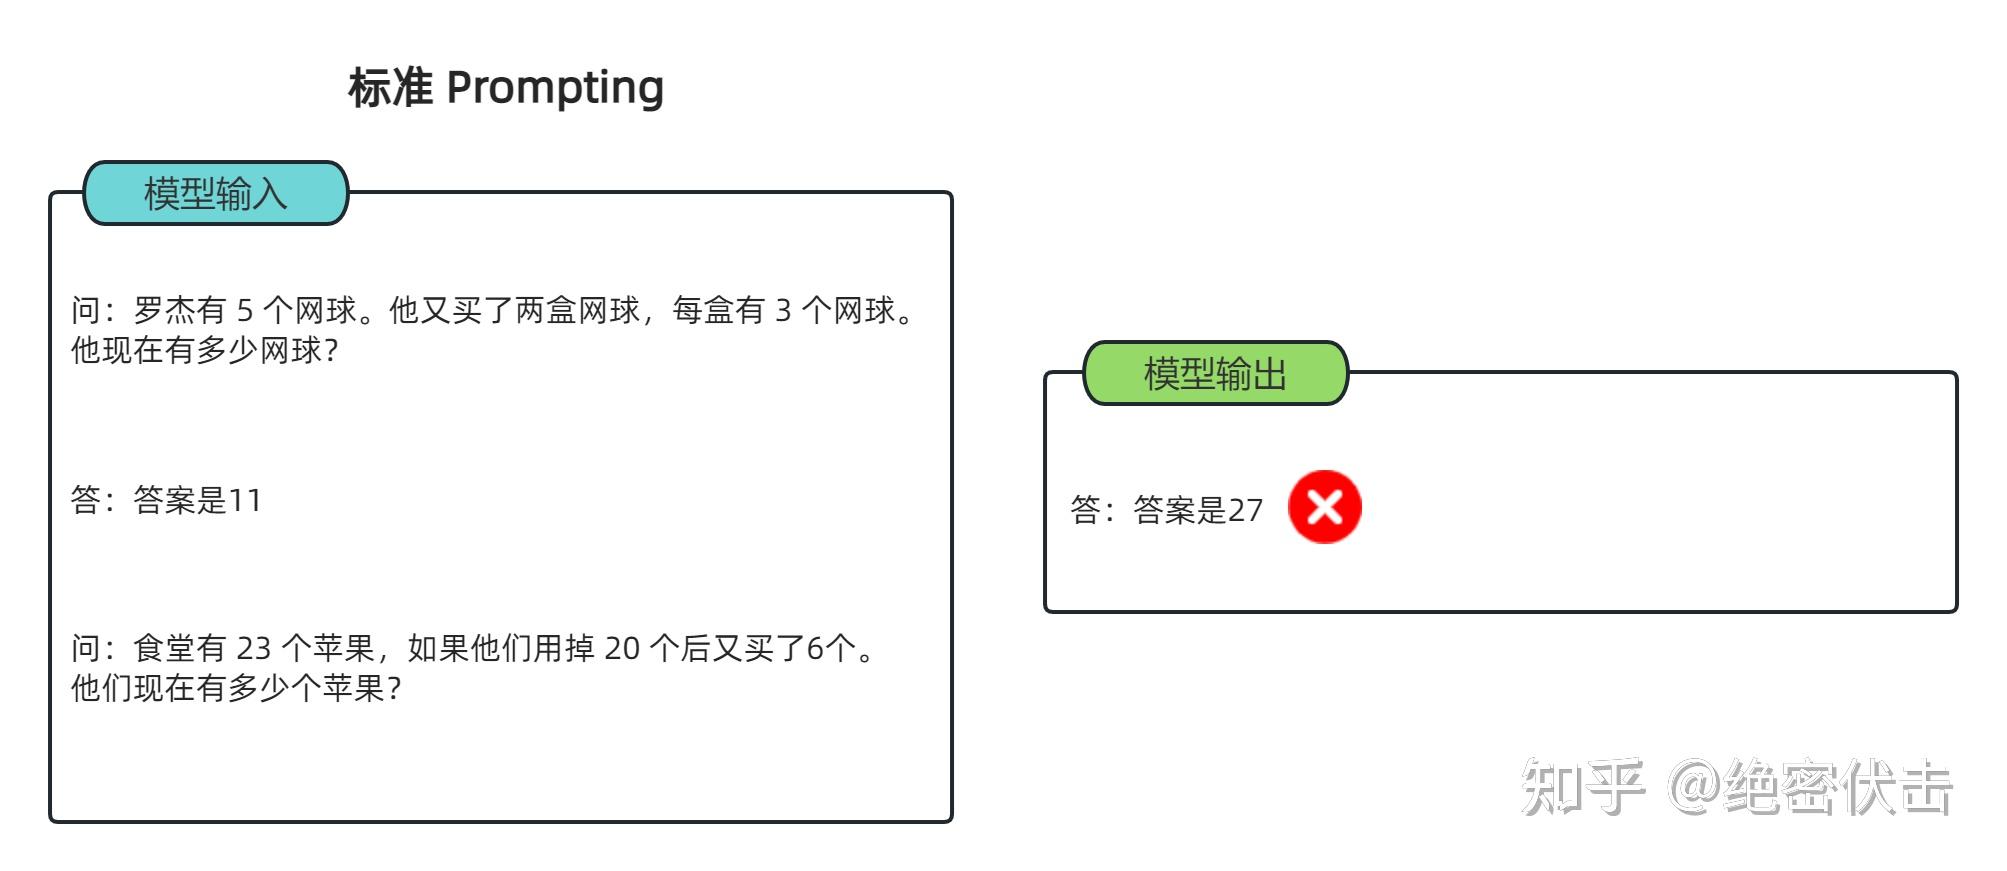
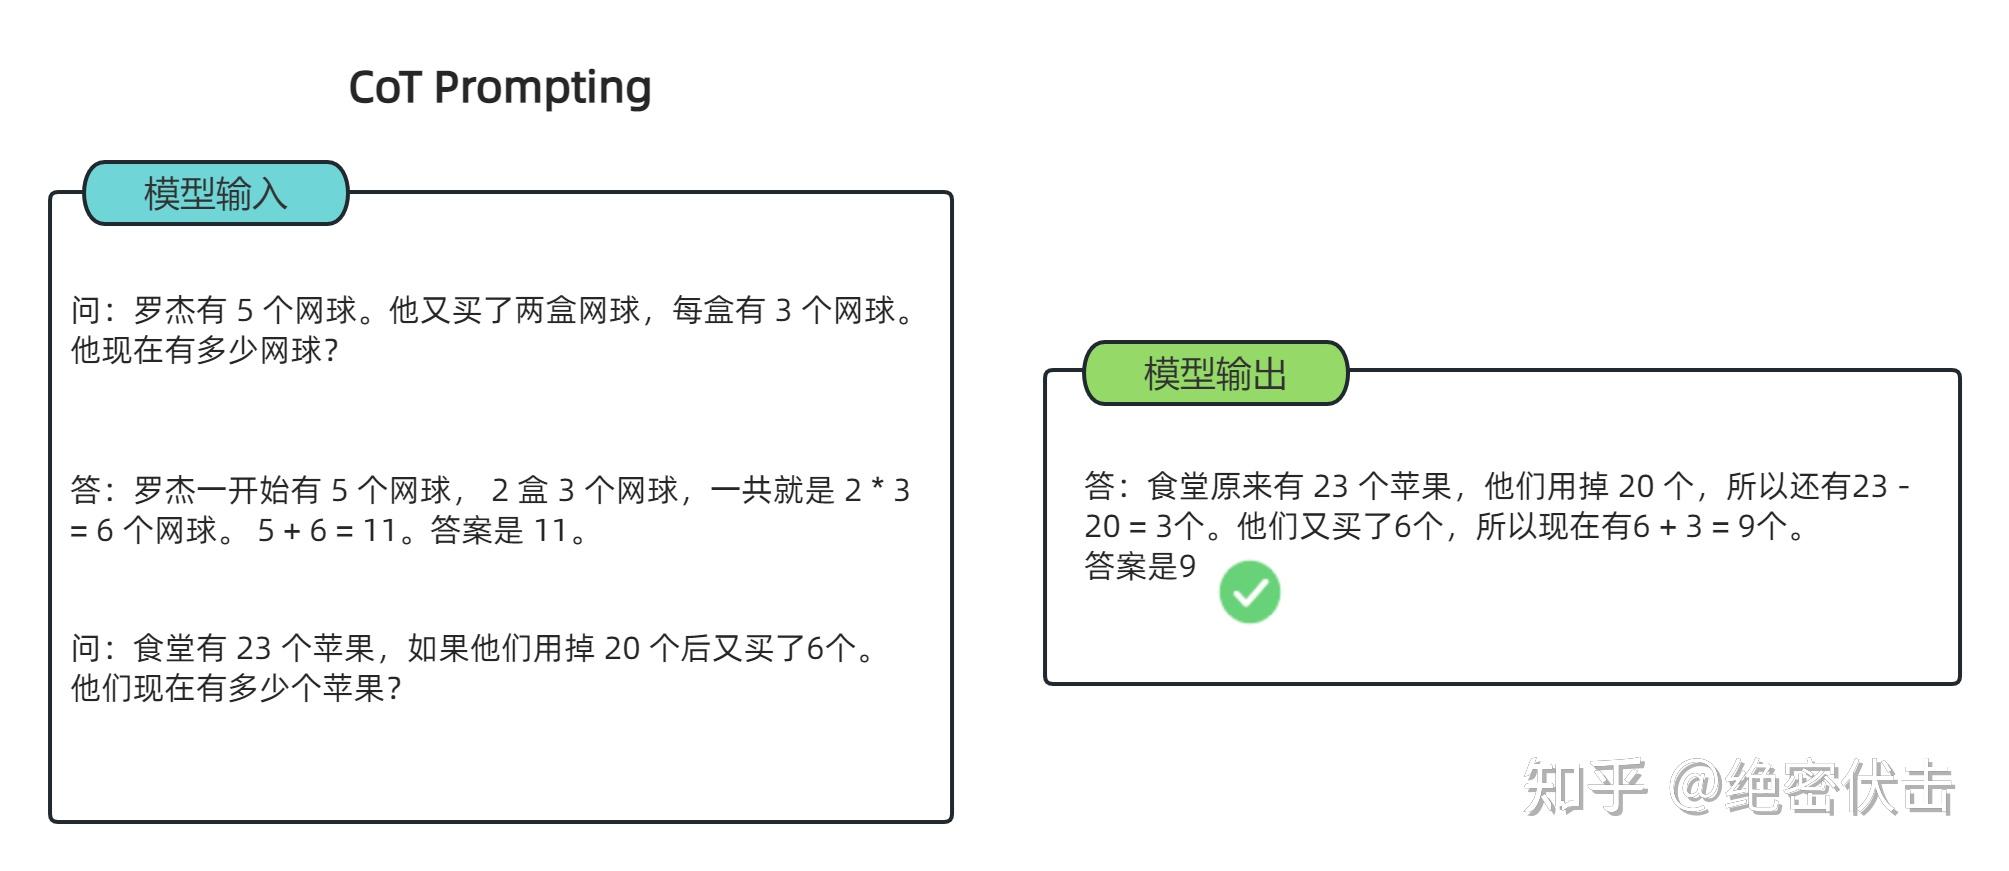
2022 年,在 Google 发布的论文Chain-of-Thought Prompting Elicits Reasoning in Large Language Models 中首次提出,通过让大模型逐步参与将一个复杂问题分解为一步一步的子问题并依次进行求解的过程可以显著提升大模型的性能。而这一系列推理的中间步骤就被称为思维链(Chain of Thought, CoT)。
谷歌之前在大模型下了很大功夫,GPT 生成式预训练模型中的“T”,也就是 Transformer,就是谷歌大脑搞出来的。但是,预训练 + 精调的大模型搞了几年,仍然没办法很好地完成多步骤推理任务,比如数学问题和常识推理。所以 Jason Wei 等人提出了思维链提示的方法,真的一下子就让大模型的逻辑推理能力不一样了。
简单来说,语言模型很难将所有的语义直接转化为一个方程,因为这是一个更加复杂的思考过程,但可以通过中间步骤,来更好地推理问题的每个部分。
思维链提示,就是把一个多步骤推理问题,分解成很多个中间步骤,分配给更多的计算量,生成更多的 token,再把这些答案拼接在一起进行求解。
工程上,我们可以使用 DSPy、LangChain 等库来构建思维链和下面提到的工具链。 扩展阅读:大模型思维链技术原理、一文读懂:大模型思维链 CoT(Chain of Thought)
就像人和动物最大的区别是会使用工具一样,大模型也可以通过使用工具来增强性能,更好地达成任务。具体来说,我们可以为大模型编写一系列的以语言为接口的工具,告诉大模型可以调用这些工具,这样就可以实现自动调用工具来进行原本实现不了的操作了,例如联网查询、控制实体机器等等。需要说明的是,由于大模型的通用性在这方面可能会比较差,所以实际使用中通常会对工具使用进行微调。
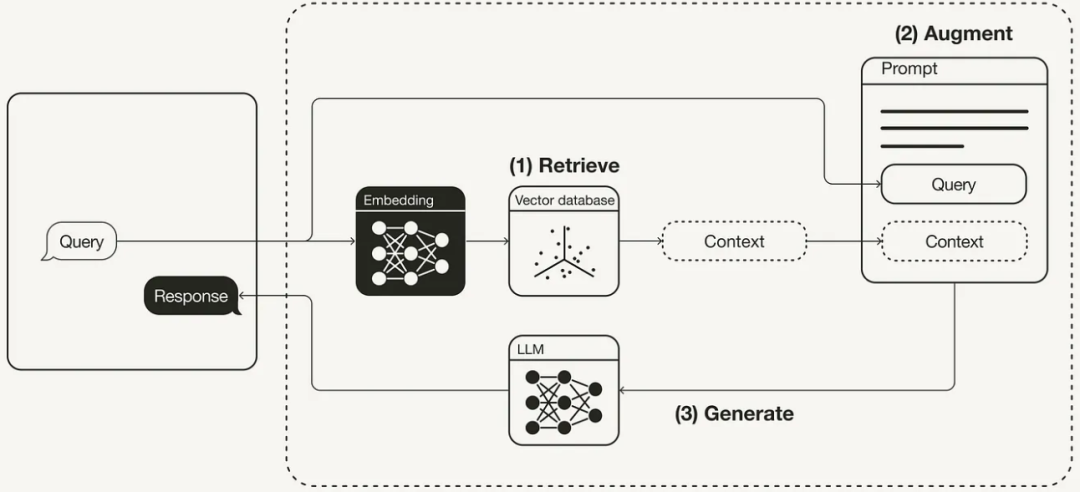
RAG 的全称是 Retrieval-Augmented Generation,中文翻译为检索增强生成。它是一个为大模型提供外部知识源的概念,这使它们能够生成准确且符合上下文的答案,同时能够减少模型幻觉。 最先进的LLM会接受大量的训练数据,将广泛的常识知识存储在神经网络的权重中。然而,当我们在提示大模型生成训练数据之外的知识时,例如最新知识、特定领域知识等,LLM的输出可能会导致事实不准确,这就是我们常说的模型幻觉。
使用 RAG,就和开了外挂一样,模型可以从知识库中获取信息,从而可以更好地生成回答。一般的 RAG 工作流程为:「检索(Retrive)」 根据用户请求从外部知识源检索相关上下文。为此,使用嵌入模型将用户查询嵌入到与向量数据库中的附加上下文相同的向量空间中。这允许执行相似性搜索,并返回矢量数据库中最接近的前 k 个数据对象。 「增强(Augment)」 用户查询和检索到的附加上下文被填充到提示模板中。 「生成(Generate)」 最后,检索增强提示被馈送到 LLM。
工程上,我们可以使用向量数据库、知识图谱等等方法来进行知识的存储,也可以使用工具链,访问网络资源进行知识获取。

就像引言说的那样,长期以来,研究者们一直在追求与人类相当、乃至超越人类水平的通用人工智能(Artificial General Intelligence,AGI)。早在 1950 年代,Alan Turing 就将「智能」的概念扩展到了人工实体,并提出了著名的图灵测试。这些人工智能实体通常被称为 —— 代理(Agent)。「代理」这一概念起源于哲学,描述了一种拥有欲望、信念、意图以及采取行动能力的实体。在人工智能领域,这一术语被赋予了一层新的含义:具有自主性、反应性、积极性和社交能力特征的智能实体。
大型语言模型(LLMs)的出现为智能代理的进一步发展带来了希望。如果将 NLP 到 AGI 的发展路线分为五级:语料库、互联网、感知、具身和社会属性,那么目前的大型语言模型已经来到了第二级,具有互联网规模的文本输入和输出。在这个基础上,如果赋予 LLM-based Agents 感知空间和行动空间,它们将达到第三、第四级。进一步地,多个代理通过互动、合作解决更复杂的任务,或者反映出现实世界的社会行为,则有潜力来到第五级 —— 代理社会。
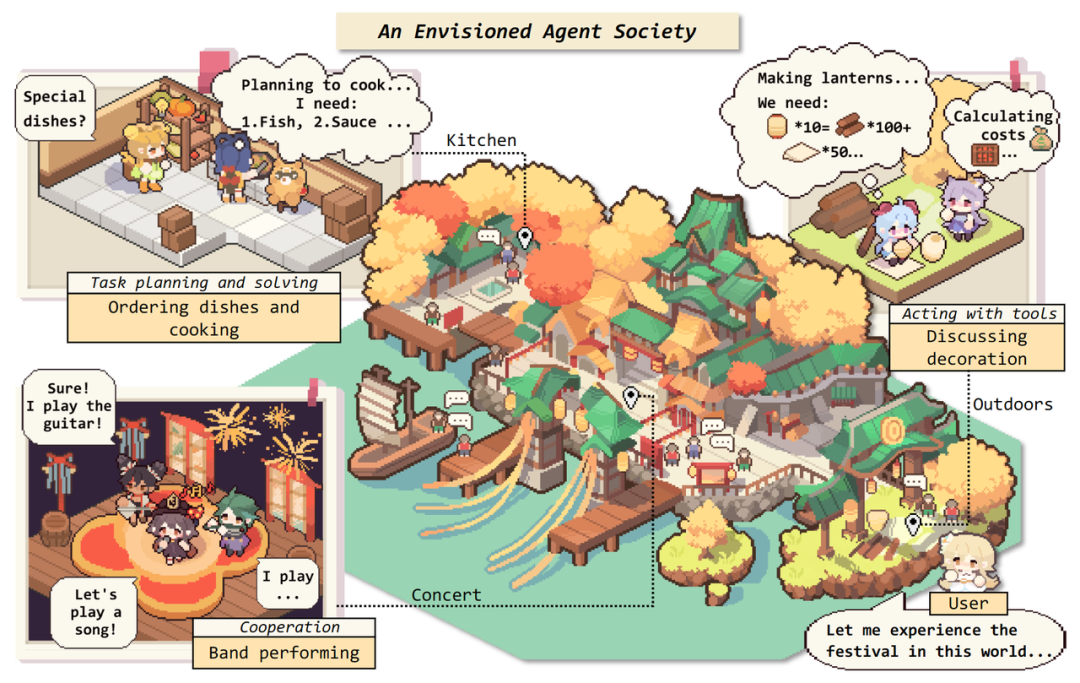
简而言之,Agent 智能体就是一个可以和环境互动的大模型,可以帮助用户从日常任务、重复劳动中解脱出来,减轻人类的工作压力,提高解决任务的效率;不再需要用户提出显式的低级指令,就可以完全自主的分析、规划、解决问题;在解放用户的双手以后,尝试解放大脑:在前沿科学领域充分发挥潜能,完成创新性的、探索性的工作。
你可以想象一下,未来的每个机器人都是一个Agent,你的个人助手是一个Agent,游戏里的每个角色都是一个Agent......可以预料到的是,未来,智能体将无处不在。 扩展阅读:The Rise and Potential of Large Language Model Based Agents: A Survey
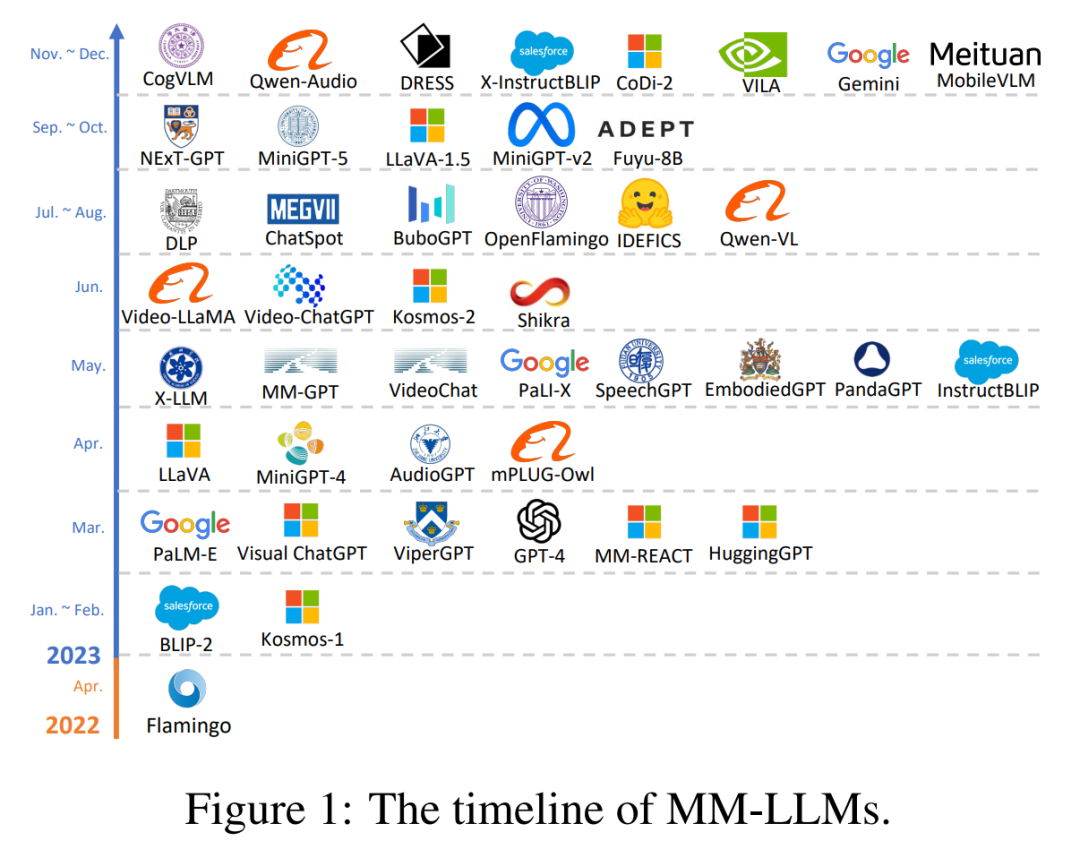
在使用大模型通往通用人工智能(AGI)的道路中,从传统的单一的“语言模态”扩展到“图像”、“语音”等等的“多模态”必然是大模型进化的必经之路。
多模态大模型脱胎于大模型的发展,传统的多模态模型面临着巨大的计算开销,而 LLMs 在大量训练后掌握了关于世界的“先验知识”,因而一种自然的想法就是使用 LLMs 作为多模态大模型的先验知识与认知推动力,来加强多模态模型的性能并且降低其计算开销,从而多模态大模型这一“新领域”应运而生。
目前最主流的方法,就是将视觉、语音等等模态的数据,通过特定的方法如编码器和投影,和大模型的语义空间匹配,从而可以让大模型理解这些多模态。 扩展阅读:MM-LLMs: Recent Advances in MultiModal Large Language Models、多模态大模型入门指南
我们可以畅想一下,大模型未来无处不在,就像当年的 PC 一样。在不久的未来,大模型将像是我们日常生活中的一位智慧朋友,无处不在而且充满了同理心。在技术层面上,随着硬件的进步和算法的优化,这些模型将变得更加高效和节能,能够在更小的设备上运行,比如手机或是家庭中的智能助手。
在应用领域,大模型将渗透到各个行业。在教育领域,它们将成为个性化学习的助力者,能够根据学生的学习习惯和能力调整教学内容和速度。在医疗健康领域,模型将帮助医生分析病历,提供诊断建议,甚至能模拟手术过程供医生训练。在商业领域,从个性化广告到供应链管理,大模型将使企业能够预测市场趋势,优化决策过程。
随着自然语言处理技术的进步,大模型将更加擅长理解和生成自然语言,这不仅使得它们能更好地与人类交流,也能创造出引人入胜的故事和诗歌,甚至编写或协作编写小说和剧本。这样的能力将使模型在文威特、艺术甚至心理咨询等领域发挥巨大作用。
在安全和隐私方面,随着模型应用的深入,对这些大模型的监管也会更加严格。数据保护将成为设计模型时的核心问题,模型将需要在保护用户隐私的前提下进行学习和优化。
最终,这些发展将使大模型不仅仅是冷冰冰的计算工具,而是人类的合作伙伴,甚至是心灵的慰藉者。如同一位理解我们情感和需求的老朋友,它们将帮助我们解决问题,激发创造力,甚至帮助我们理解和表达我们自己的情感。可扩展性问题数据偏见与模型公平性安全性与隐私问题...跨模态学习更智能的自然语言理解AI伦理与治理强化学习...Prompt(提示): 在自然语言处理中,prompt通常指向模型提供的一个或一系列文本输入,用于引导或激发模型生成特定的输出。在大模型的使用中,如GPT系列,prompt是启动生成过程的关键元素。它最初是 NLP 研究者为下游任务设计出来的一种任务专属的输入形式或模板,在 ChatGPT 引发大语言模型新时代之后,Prompt 即成为与大模型交互输入的代称。即我们一般将给大模型的输入称为 Prompt,将大模型返回的输出称为 Completion。 Tokenization(分词): 分词是NLP中将连续文本分解为可管理和分析的单元(如单词、短语或字符)的过程。这是文本预处理中的基本步骤,对于构建语言模型至关重要。 Embeddings(嵌入): 嵌入是一种将文本中的单词或短语转换为向量的技术。这些向量捕捉到了丰富的语义属性,使得具有相似意义的单词在向量空间中彼此接近。 Attention Mechanism(注意力机制): 注意力机制是一种使模型能够在处理信息时自动对重要部分给予更多关注的技术。它在处理复杂的输入序列(如长文本)时特别有用,帮助模型集中注意力于相关信息。 Backpropagation(反向传播): 反向传播是一种在神经网络中用于优化模型参数的算法。通过计算误差函数相对于网络参数的梯度并反向传播这些梯度,它帮助模型学习和改进。 Loss Function(损失函数): 损失函数是衡量模型输出与真实值之间差异的函数,是训练过程中优化的目标。选择合适的损失函数对于模型的性能至关重要。 Transfer Learning(迁移学习): 迁移学习是一种机器学习技术,通过重用一个在类似任务上训练好的模型为基础,适应并提高在新任务上的性能。这种方法在NLP中广泛使用,尤其是在数据稀缺的情况下。 Hyperparameters(超参数): 超参数是在训练过程开始之前设置的参数,如学习率、批处理大小或训练的轮数。它们不同于模型训练过程中学习的参数,对模型的性能和训练速度有重大影响。 神经网络(Neural Network): 神经网络是一种受人类大脑启发的计算模型,能够通过模拟大量互连的神经元处理复杂的数据输入。它是构建大语言模型的基础。 自然语言处理(Natural Language Processing, NLP): 自然语言处理是人工智能领域的一个分支,专注于使计算机能够理解、解释和生成人类语言的数据。大模型在这一领域中扮演了核心角色。 监督学习(Supervised Learning): 在监督学习中,模型通过训练数据集学习,该数据集包含输入和预期输出。训练过程中模型尝试最小化预测错误,并通过反复调整来优化性能。 Transformer: Transformer是一种深度学习模型,广泛用于处理序列数据,如文本。它的核心机制是自注意力(self-attention),能够处理输入序列中不同位置之间的依赖关系。 微调(Fine-tuning): 微调是一种常见的机器学习技术,用于通过在特定任务上继续训练已预训练的模型来调整其参数,以提高特定任务的性能。 多任务学习(Multi-task Learning): 在多任务学习中,模型被同时训练来执行多种相关任务。这种方法可以提高模型的泛化能力,并通过共享学习到的特征来提高各个任务的性能。
现在,虽然多数大模型主要基于 Transformer,但是还是有很多表现很好的大模型架构,这里列举一些主流的架构进行简介:Transformer架构
Transformer模型自2017年由Google的研究者提出以来,已经成为最为广泛使用的模型架构之一。其核心思想是使用自注意力(Self-Attention)机制来处理序列数据,这使得模型能够更好地理解数据中的长距离依赖关系。Transformer架构摒弃了以往的递归网络和卷积网络,完全基于注意力机制构建,极大地提高了模型处理大规模数据的能力和效率。BERT (Bidirectional Encoder Representations from Transformers)
BERT由Google在2018年推出,基于Transformer架构,通过双向训练的方式来更全面地捕捉上下文信息,显著提高了模型在多种NLP任务上的表现,如问答系统、情感分析和语言推断等。BERT的一个关键创新是其预训练任务设计,主要包括掩码语言模型(Masked Language Model)和下一句预测(Next Sentence Prediction),这些设计使得BERT能够更好地理解语言的双向流动性。GPT (Generative Pre-trained Transformer)
GPT系列模型由OpenAI开发,是一种基于Transformer的自回归语言模型,通过预训练和微调的方式适用于各种语言处理任务。从GPT-1到最新的GPT-4,每一代模型都在规模和复杂性上有显著增加。GPT模型的主要特点是其生成能力,即能够根据给定的文本输入生成连贯、相关的文本输出。T5 (Text-to-Text Transfer Transformer)
Google在2019年推出的T5模型进一步扩展了Transformer的应用,将所有文本处理任务统一为一个“文本到文本”的格式,这意味着模型对所有任务的输入和输出都是文本。这种设计简化了不同任务之间的转换过程,并提高了模型的灵活性和通用性。ERNIE (Enhanced Representation through kNowledge Integration)
百度的ERNIE模型是在BERT的基础上进一步发展的,通过整合知识图谱中的结构化知识来提高模型对语言的理解能力。ERNIE模型特别强调在预训练阶段加入实体级信息,以更好地处理语言中的实体和常识相关的问题。DeBERTa (Decoding-enhanced BERT with Disentangled Attention)
微软推出的DeBERTa模型在BERT的基础上进一步创新,引入了解耦注意力机制,该机制区分了不同词之间的内容和位置关系,提高了模型捕捉句子内部结构的能力。此外,DeBERTa也在多项NLP基准测试中取得了先进的性能。LLaMA (LLaMA: LLM for Academia)
LLaMA(大型语言模型学术版)是由Meta AI在2023年发布的一种新型的Transformer模型。LLaMA旨在为学术界提供一个更可接近、可调整的大型语言模型框架。LLaMA模型的特点在于其规模的灵活性,发布了不同大小的版本,从7亿参数到65亿参数不等,以适应不同的硬件和研究需求。此外,LLaMA模型在预训练阶段采用了高质量和多样化的数据集,强调了对事实正确性和信息准确性的重视,尤其在学术和专业领域中表现出色。GLM (Generative Language Model)
GLM 系列是由清华智谱推出的生成语言模型,它专注于优化对话系统的性能。该模型在设计时特别考虑了对话的连贯性和上下文依赖性,使其能够在聊天机器人和类似应用中提供更流畅和自然的交流体验。ChatGLM采用了多种新颖的训练技术,如对话意图识别和情感分析的集成,旨在提升模型对人类语言的理解深度和响应的相关性。RWKV
在Transformer时代,介绍一个非Transformer架构的新网络——RWKV,RWKV是一种创新的深度学习网络架构,它将Transformer与RNN各自的优点相结合,同时实现高度并行化训练与高效推理,时间复杂度为线性复杂度,在长序列推理场景下具有优于Transformer的性能潜力。Transformer网络的内存和计算复杂性随序列长度二次方缩放,而循环神经网络RNN只需线性缩放。但RNN在并行化和可扩展性方面存在限制从而难以达到Transformer的能力。RWKV-LM/ChatRWKV是基于RWKV预训练的非Transformer架构的百亿级参数语言基础模型/对话模型,具有与Transformer架构LLM相当的能力并且计算效率更高(计算快,资源占用小)。
在信息的宽广海洋里,语言模型像是勇敢的航海者。这些智能的实体从早期的简单结构演变成现在的复杂系统,其历程充满了探索和创新。
一切始于20世纪50年代,人们开始构想计算机能像人一样处理和理解语言。这个时期,语言模型还是个稚嫩的婴儿,学步艰难,尝试通过简单的规则来模拟语言的结构。
随着时间的推移,70年代和80年代的统计模型逐渐登场,它们开始学习大量文本中的规律,尝试从中寻找语言的模式。这一时期的模型,如隐马尔可夫模型和n-gram模型,虽然简单,但为未来的发展奠定了基础。
进入21世纪,随着计算能力的飞速发展和数据量的大幅增加,机器学习技术开始崭露头角,语言模型迎来了青春的躁动期。特别是2013年后,深度学习技术的运用使得模型不仅能模拟语言,更能理解和生成前所未有的复杂文本。这一时期的标志是Word2Vec、LSTM和Transformer等模型的出现,它们像是青春期的语言模型,好奇而又充满活力,对世界的理解更加深刻。
最终,我们迎来了现在的巨型神经网络,如OpenAI的GPT系列,它们可以生成诗歌、新闻甚至代码,仿佛已经掌握了语言的精髓。这些模型不仅仅是机器,更像是拥有自己思想的智者,他们在虚拟的世界中不断学习,不断进化,向着未知的深度航行。
随着技术的发展,语言模型的航程也愈发精彩。这些模型不仅掌握了文字,还开始尝试理解语音和图像,试图打破单一模态的限制,向多模态学习迈进。
在2010年代中期,随着深度学习的兴起,一些新的架构如卷积神经网络(CNN)和循环神经网络(RNN)开始在语言处理领域显示出强大的能力。这些模型在处理语音和视频数据时展示出了前所未有的效果,使得机器能更好地理解人类的多种交流方式。
到了2018年,Google的BERT模型的推出,开启了一个新的里程碑。BERT利用了所谓的“Transformer”架构,这一架构设计允许模型更加有效地处理长距离的依赖关系,极大地提高了模型对文本的理解深度。这种技术让机器能够更好地理解上下文,甚至能够把握句子中的隐含意义。
接着,多模态模型如OpenAI的CLIP和DALL-E的出现,将文本与图像处理结合起来,展示了通过视觉和语言联合理解世界的潜力。这些模型能够理解图片内容并生成描述,或者根据文本提示创造出全新的图像,这在以前是难以想象的。
此外,自然语言处理的应
用也在不断扩展,从最初的机器翻译和语音识别到现在的自动摘要、情感分析和虚拟助手等。这些应用正在改变我们的工作、学习甚至日常生活的方式。
随着技术的不断进步,语言模型正逐步从纯粹的语言理解走向更广泛的认知能力。未来,它们可能会更加深入地理解复杂的人类情感和文化差异,更好地服务于全球化的世界。
这一切都证明了语言模型是人工智能领域中最富创新力和变革力的分支之一,它们的发展不仅推动了技术的边界,更拓展了我们对人类语言乃至智能的理解。
[待更新......]
参考文章均已链接的形式在文中给出,这里就不再总结了。