2014 年注册的美国 Gmail 老账号 | 短信验证 | 已启用双重验证 | 包含备用邮箱
DESCRIPTION / 资源参数说明
庄子与惠子游于濠梁之上。庄子曰:“鲦鱼出游从容,是鱼之乐也。”惠子曰:“子非鱼,安知鱼之乐?”庄子曰:“子非我,安知我不知鱼之乐?”惠子曰:“我非子,固不知子矣;子固非鱼也,子之不知鱼之乐,全矣!”庄子曰:“请循其本。子曰‘汝安知鱼乐’云者,既已知吾知之而问我,我知之濠上也。”——《庄子·秋水》
引子
2022年11月30日,美国人工智能研究公司OpenAI上线了一款基于生成式模型GPT-3.5的聊天机器人ChatGPT。
推出仅两个月后,这款基于生成式智能的聊天机器人便突破了 1 亿的月活用户,成为史上用户增长速度最快的消费级应用程序。
结合由 Dall·E、Midjourney 等人工智能生成内容(AIGC)技术掀起的人工智能应用浪潮,ChatGPT及其相关竞品们的表现让人们开始相信:距离实现通用人工智能、开启人类新纪元的里程碑已经不远了!
2023 年,OpenAI 团队又快速迭代到了新一代的 ChatGPT,并在《通用人工智能火花:关于 GPT-4 的早期实验》一文中展现了新版本机器人的“全面”表现。
随着 ChatGPT 的不断迭代,以及各类竞品的追赶。全世界在面对一众能自如地使用自然语言表达、看起来具备推理和规划能力的(甚至最近出现了能提供情绪价值的对话机器人)智能机器,产生了数百万年前人类祖先发现燧石取火时那种惊诧的反应。人们开始谈论,媒体愈发喧嚣——大家仿佛一下子被推上了一列向某个不可控又未知目的地狂奔而去的高速列车上。
列车的推背感下,有的人忧心忡忡——“基于大模型的通用人工智能技术将很快取代大部分人的工作”“人工智能将导致人类的存在性危机,并在不远的未来被奴役、控制甚至毁灭”“人工智能被运用在社会工程、公众隐私监控甚至军事中将造成不可想象的后果”;有的热血澎湃——投入到拥抱通用人工智能技术、开创全新应用、商业、创作的「信仰之跃」中;有的琢磨——琢磨如何卖铲子,如何搞泡沫,如何操纵新的意识形态;有的在憧憬——被通用人工智能所赋能的“美丽新世界”(中性词)会是什么样。
每一波技术浪潮也在帮助人类(至少一部分人)反思自我、重塑对自己和世界关系的认识。这次也不例外。
其中一个有趣的问题是:生成式大模型学习了大量的人类知识,但这等于它们理解了这个世界吗?
对这个问题,美国路易斯威尔大学人工智能安全和网络安全专家罗曼·杨波尔斯基(Roman Yampolskiy)教授在莱克斯·弗里德曼(Lex Fridman)的播客上进行了相关讨论。他们认为生成式人工智能对世界形成了一定的理解,但却是不完备的——“它的全部世界观就是‘我想要它’,它根本就不具备理解‘我为什么不要’的能力”,“我们可能无法理解它在做什么以及为何去做,甚至无法与它进行有意义的交流。”
在这个例子里,涉及到了两种理解的概念。一种是对外部世界的理解,另一种是智能机器的行为对人类来说是不是可理解的(或者说可解释的)。两个概念的关系其实很微妙。
本期文章就来谈谈这个问题。
基于预测的「理解」
对于智能机器是否「理解」了我们的世界,众说纷纭。
相信阅读本文的你,多少或体验或听闻当前生成式语言大模型在这类任务的强大预测表现。有些实验甚至得出结论:生成式大语言模型已经通过了图灵测试,在跨多项认知任务上达到甚至超越了人类。
这个分数,还在不断刷新。
本质上,基于 Transformer 架构的生成式大模型主要在做的是「预测性生成」:当输入一段话,(例如 ChatGPT)将预测出这段话之后的下一个词(严格来说是比词更小的单位“词元”,在此就不深究了);在其它模型中,预测性生成的也可能是:输入的段落中有些被遮挡的词,根据上下文提供的内容,像做完形填空一般填补这些空缺。
这类学习也叫自监督学习。就像在人类语言学习过程中(比如英语),通过上下文学习一样。
当人们提问或者对话时,基于生成式大语言模型的聊天机器人接受用户的输入内容(在多轮对话种还包括先前的对话记录,对模型来说也就是“上下文”),接着便不断重复上述生成下个词的操作——每次生成一个词或者少数几个词,追加到原输入末尾,然后作为新的输入——这个过程直至达到某个停顿(句子结束,或者到最大输出限制时)为止。最后将所有在本轮生成的词序列作为输出,反馈给用户,等待下一轮或者结束对话。
整个过程中,模型所维持的对话记录可与人类的短期记忆中的工作记忆(working memory)进行类比,这对于聊天机器人维护对话内容的上下文非常重要。对此,近期谷歌研究团队近期的工作《TransformerFAM: Feedback attention is working memory》便作了相关探索。此外,斯洛伐克裔加拿大计算机科学家安德烈·卡帕西(Andre Karpathy)谈及了这个观点,他曾任特斯拉人工智能和自动驾驶视觉总监。这个话题非常有意思,后面讲「记忆」的时候还会讨论到。
那么,大模型的预测表现可以和智能的理解划等号吗?
对于“预测”和“理解”的关系,从计算智能(也就是人类的智能行为可以通过计算的方式实现近似或者等价的模拟)角度一般有两种观点。
一类观点以「预测」为中心,认为智能的本质就是预测——即广义上的模式识别,从文本、图像、数据中挖掘并学习潜在模式,并做出相应的预测(执行任务)。挖掘的模式即蕴含了对外部世界的表征(通常认为是高维空间的低维流形表征,掌握这个模式相当于把握了世界规律,也便蕴含了对世界的理解。
这个表征形成在大脑之中,后者正如一台长期不罢工的自动机器,对周围发生的一切持续地更新这个表征与预测。这个过程常常发生在我们的意识之外——正如德国物理学家、生理学家亥姆霍兹的观点:我们的知觉系统不是一台单纯的复印机,而是会将知觉信息在我们无意识阶段以某种最佳推测方式拼凑在一起。
支持预测中心论观点的大有人在。
例如,前OpenAI首席科学家伊利亚·苏茨克维(Ilya Sutskever)坚信通过构建超规模“数据+算力”人工智能训练方案,生成式人工智能程序将最终涌现出(超越)人类水平的智力。在他的带领下,ChatGPT 横空出世。伊利亚在两年前曾接受知名播客ClearerThinking主理人斯宾塞(Spencer Greenberg)的采访。当斯宾塞问到“ 预测和理解之间有着怎样的联系”问题时,伊利亚说道:直观来说,假设有某个系统可以非常出色地猜测文本中(或者其他模式中)接下来会出现的内容,那么为了做到这一点,它必须具有相当程度的理解。
对此,伊利亚给了个例子:假设你已经读完一本侦探小说,现在翻到了小说的最后一页。在最后一页的某处,有一句话,侦探即将宣布罪犯的身份。然后有一个词,这个词就是罪犯的名字。在这一点上,系统将猜测下一个词。如果系统表现得非常非常出色,它将对那个名字的猜测范围缩小到两三个人名选项。如果神经网络非常仔细地“注意”到小说中的细节,并且有一定的推理能力,那么最终才能比较准确地猜到谁是罪犯。换句话说,如果神经网络能够有效预测下一个词,也就是罪犯的名字,那么这足以说明它已经对小说有了深度的“理解”。这便是预测和理解之间的,至少直观的,联系。
在另一个采访当中,伊利亚补充道:当我们训练一个大型神经网络来准确预测不同文本中的下一个单词时...它正在学习一个世界模型... 这个文本实际上是对世界的一个投影...神经网络正在学习更多关于世界及人类的动态,他们的希望、梦和冲动方面...神经网络学习了一个压缩的、抽象的、可用的表征。
换句话说,在生成式大模型中,预测蕴含着某种描述“世界内在机制模型”,而后者已经隐式地被编码在模型中。这样一个机制,正如脑科学及神经科学家们所坚信的那样,也以某种方式存在于人们的大脑中,以新皮质为主协同不同的功能脑区得以实现。
公认的“当代人工智能教父”杰弗里·辛顿(Geoffrey Hinton),同时也是伊利亚曾经的导师,在某次采访中也表达了类似的观点:当智能机器可以根据所提供的信息,确定你的意图,预测并输出期望的答案时,它就已经蕴含了「理解」。接下来的问题是「理解」的程度能否匹配甚至超越人类。他担忧的是这一天或许很快会来临,而人类却还没准备好如何应对。
换句话说,如果智能机器能通过高级模式识别能力,持续、一致地实现有效预测并驱动相关行为,那它便可以称为是“智能”的(并蕴含了理解能力)——这个观点和阿兰·图灵提出模仿游戏这一思想实验时观点相似,尽管图灵当时其实是绕开了“机器能否思考”这一问题。
那么,生成式大模型目前能持续、一致地输出预期性的答案吗?
纽约大学心理学与神经科学荣休教授盖瑞·马库斯(Gary Marcus)和计算机科学教授欧内斯特·戴维斯(Ernest Davis)通过实验观察到:ChatGPT的概率性生成本质,导致其生成的内容可能存在偏见、歧视、虚构信息;无法进行真实世界推理,无法将人类思维和性格联系起来,也无法准确排列故事中的事件顺序。
很显然,按照前面定性的描述,目前的生成式大语言模型的概率性输出特征,让它们更像是富有经验但不懂统计学的赌鬼,在应对新的赌局(文本预测)时基于他的经验甚至直觉所作出的一系列判断。而大部分的外行人(我们,毕竟它们的阅读量远超大部分人)不一定能立即察觉。
当机器解答所包含的语法结构和内容,复杂到足以为使用者提供相当的(甚至意外的)信息量,同时以人类可理解的方式完成表述,那么人们似乎倾向于将它们“拟人化”,这似乎是人天生的一种倾向或者被动技能。
我的看法是:目前生成式大模型令人吃惊的关键,不在它们产生了符合预期的回答,更可能是它们给出了足够丰富的不同于我们预期的“多样性”解答,并且在部分问题上达到了“预期”,而在没有实现预期的问题上被忽略或者低估了(算得上某种幸存者偏见),从而带给了人们「理解」的错觉。
毕竟,人们并不总是对自己提出的问题有充分而固定的预期。尽管有越来越多的问答基准测试集评估不同大模型的智力得分,但也有相关研究表明在与用户交互过程中,大模型对问题的理解等主观体验评分和它们在基准智力测试中的表现并无显著的正相关性。
不过,为了让机器们少“胡言乱语”,全世界的工程师与科学家也在不断开发新的技术,降低这种概率性生成所带来的结果不稳定与不一致性。
然而,沿着当前这条技术路径,就算未来这类的智能机器预测表现极佳,但出色的预测便蕴涵“理解”了吗?
答案似乎并没有那么肯定。
将「预测」看作智能的本质,并把「理解」看作展示智能行为所蕴含的推论,难以令所有人信服。
早在几十年前,美国哲学教授约翰·瑟尔在他的论文《心灵、大脑和程序》提出了著名的“中文屋”思想实验,以驳斥当时关于强人工智能的一些观点。一个只懂英语而不懂中文的人被关在一个只有一个开口的封闭房间里。房间内有一本用英文书写的手册,告诉他如何处理收到的中文消息,以及如何用中文来回复。房外的人不断用中文写成的问题传递给房间内的人。房间内的人根据手册的指示查找适当的信息,将中文字符组合成问题的答案,并把答案给到房外的人。
瑟尔认为,尽管房里的人能模仿中文表达,却不是在真正理解中文的前提下进行回答,称不上真正的「理解」。
基于这个设定,如果我们将房外人看作人类测试者,房内人看作人工智能程序,手册是人工智能程序通过学习进而掌握的跨语言符号的映射关系。瑟尔不认为这说明人工智能理解了语言,更谈不上通过语言理解了世界。在人类和动物大脑的智能机制中,理解和意图(作为一种行为自驱力)是分不开的。
那究竟是什么区分了「真的理解」和「表现出的理解」呢?如果真正智能的理解离不开自驱力,那么自驱力的基础又是什么呢?
预测背后的「理解」
除了“预测中心论”外,还有另一类观点:智能的本质是“模型构建”(model building)——也就是根据情境快速构建抽象模型,并基于该模型去理解环境动态,据此推测可能的行动后果(反事实推理)并规划行动。
这类观点出发点是人类生物受限于碳基生命的能耗限制,必须从外部纷繁的感知与信息中提取对生存有利的信息,构建灵活的抽象模型,从而展开环境分析、预测和行动。
比如,足球比赛中,持球球员需要实时建立并更新周围一定区域内敌我球员的相对位置和动态模型,并据此决定下一步的行动动向以及对球的处理。此时,他们不会关注球场上的哪根草被压弯了,更不会关注边线旗帜是不是被吹歪了——在他们看来,球赛是在一个理想平面上进行的,旗子和场边人员(大多时候)被排除在模型外。
再比如,当马路上的小车要转弯时,驾驶员可能会将车看作一个抽象的带轮子的长方形,而乘客则把车看作一个移动的半封闭空间,关注车内环境或者窗外的风景(或者是自己正在冲浪的网页)。当发生交通事故时,赶来处理事故的交警关注的是事故现场状况,车子成了现场中的事故主体。当汽车送去维修时,修理师傅把车看作有复杂传动装置的机器,进行检修。
上述例子说明,处于不同的视角与角色的人们大脑中所构建(或者激活)的模型是不同的。
在「模型为中心」的观点看来,尽管智能机器表现出一定程度的智能行为,但不代表它们是通过灵活有效的模型构建来把握外部世界和行动规划的。相反,许多智能机器不过是在走某些捷径,以我们很难分辨的方式模仿相似的预期行为。
当前的生成式人工智能在一定程度上模拟了神经元的激活模式。尽管我们有理由相信它们某种程度上实现了一定的模型构建能力,然而在被问及关于物理世界的问题时,它们却无法产生符合物理世界逻辑(至少从我们直觉看来)的解答,而是生成了怪异的语言及图像。
它们看起来就像是被发条(提示词)驱动的机器鹦鹉,对自我存在以及物理世界没有持续且一致的认知——或者叫“世界模型”。
因在深度学习领域做出卓越贡献而获得图灵奖的杨立坤(Yann LeCun)认为:当前包括大语言模型在内的人工智能系统,并未真正理解我们的世界,原因在于当前的模型仅在学习各种捷径完成任务,而没有实现对于世界的完备理解(也称为“世界模型”)。
有些吃瓜群众认为,杨立昆是因为看到基于 Transformer 的兴起盖过了其它重要的人工智能模型(尤其是他早些年提出的卷积神经网络)的光芒而屡次批判当前的大模型之路。然而,这又何尝不是一种“走捷径”(也颇有调侃意味)的推论。但凡多看些人家的访谈(或者他的《科学之路》一书),不难发现杨教授是有他的立据的。
他的观点基本与目前学界的共识大体一致。比如,生成式大语言模型对逻辑的理解非常有限,没有把握物理世界的规律,没有持久的记忆,不能进行鲁棒推理等等.. 目前简单的技术规模化不会导向通用人工智能,甚至人类的存在性危机。
然而,杨立坤进一步指出:要赋予机器真正的智能,得让机器通过观察来学习世界模型。为此,他提出了一类围绕自监督学习机制(简单理解就是不需要人类的监督)的自主智能系统架构。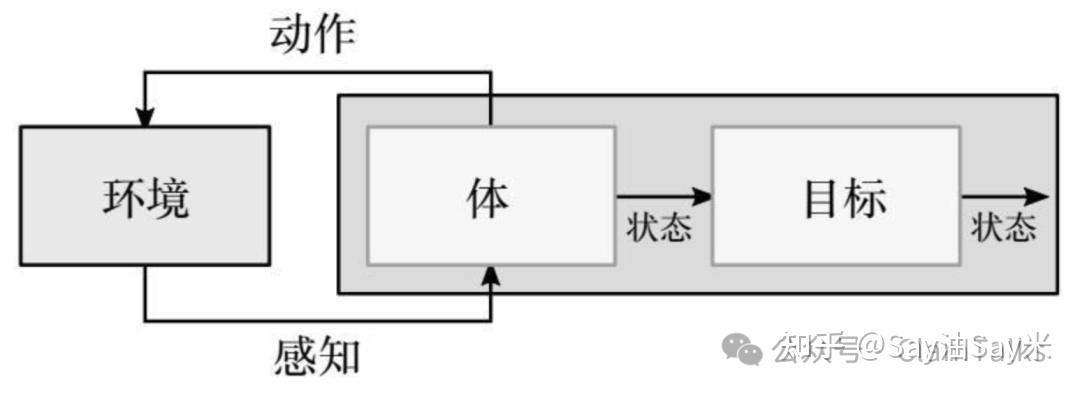 LeCun 的代理模型
在这个架构当中,智能体(灰色框框)通过感知外部信号形成对周围环境的抽象表示,同时这个状态会被呈现给智能体内部的目标模块,后者可以看成是决定智能体情绪的一个计算装置。根据环境状态,目标模块会给出对于当前环境状态的评价,并反过来驱动智能体在环境当中做出下一步行动(比如站在锅炉旁,温度过高产生“立即逃离”的信号)。可以简单将目标模块理解为“切换”不同模型(激活不同记忆痕)的操作杆。
杨立坤认为:现今大多数人工智能模型是外在动机驱动的,驱动力通常来源于外部人类的意图或评价(例如基于人类反馈的强化学习)或者人类的指导(对数据的标签分类)。同理,当前的大语言模型对话的目标也只是表现出“在预训练或者调优时获得更高评分”的行为,并非内在驱动所致。
这一观点不仅涉及世界模型,也包含另一个非常重要的元素,即自驱力。我们稍后再谈。
在计算智能领域之外,比如语言学家们是怎么看的呢?
乔姆斯基在一篇专栏文章《The False Promise of ChatGPT》中提到:我们从语言学和知识哲学中知道,它们与人类推理和使用语言的方式有着很大的不同... 人类思维不像 ChatGPT 及其同类产品那样,是一个笨拙的模式匹配统计引擎,它吞噬数百 TB 的数据并推断出最有可能的对话响应或最有可能的科学问题答案。相反,人类思维是一个令人惊讶的高效甚至优雅的系统,它仅使用少量信息即可运行;它寻求的不是推断数据点之间的绝对相关性,而是创造解释。
乔老认为:生成式人工智能目前还停留在认知进化的前人类或非人类阶段。它们最大的缺陷是缺乏任何智能最关键的能力——不仅需要描述和预测,还需要在假定某些因果机制或者物理定律的情形下展开思考。对此,他还说道:它们“学习”,却无法区分可能和不可能... 人类可以有限制地合理推测与解释,而机器学习仅仅是概率性的——地球可以是平的,也可以是圆的。... 真正的智能还具有道德判断力。这意味着用一套道德原则约束我们大脑原本无限的创造力,这些原则决定了什么该做,什么不该做。... ChatGPT表现出类似平庸之恶的东西:剽窃、冷漠和回避... 辩称自己无知、缺乏智慧,提出“只是服从命令”的辩护,将责任推给其创造者。... 简而言之,ChatGPT 及其同类系统本质上无法平衡创造力与约束。它们要么过度生成(既产生真话又产生假话,支持道德和不道德的决定),要么生成不足(对任何决定都表现出不承诺,对后果漠不关心)。
对于生成式大语言模型,另一位语言学家史蒂芬·平克(《语言直觉》一书作者,但我更喜欢他的《风格感觉》)将它们看作一类扩展人类思考能力的工具,促进人们对智能的反思。他在哈佛校报中这样评论道:我们都对人际间的因果关系有着深刻的直觉。一个收藏家可能会花10万美元买下约翰·肯尼迪的高尔夫球杆,即使它们与那个时代的任何其他高尔夫球杆没有区别。对于类似故事和社论这样的知识产品,对真实性的要求甚至更为强烈... 未来可能成为”语义搜索引擎“... 真正的语义搜索引擎会有一个“世界模型”(但不是当下的大语言模型)。它会有人物、地点、物体和事件的符号,以及目标和因果关系的表示,更接近人类思维方式。... 它们可能帮助我们了解人类智能的本质。
相比乔老,史蒂芬明确提到了“世界模型”。这类模型——源于人们的先天知识结构或由后天外部经验所塑造——正是当前生成式大模型所缺失的。
除非智能机器(以我们能解释的方式证明或者显式地引入)拥有与人类相似的灵活的模型构建能力,否则,我们无法断言它们理解了世界。
接下来,让我们谈谈世界模型。
世界模型
世界模型听起来似乎无所不包。围绕世界模型的观点和讨论,要么让生成式大模型更加神秘——比如OpenAI发布文生视频大模型Sora之后,人们开始争论 Sora 是否已经实现世界模型。
那什么是世界模型呢?
世界模型是认知科学领域的一个概念,通常被定义为:现实世界中保留关键结构的实体和过程的因果抽象,包括那些具有三维形状和物理属性的对象、具有空间结构的场景以及具有信念和愿望的代理。
有点拗口。
想象一下,世界模型好比是我们大脑中的一张巨大地图。这张地图记录着我们对外部环境的关键信息,包含了各种事物之间的位置、关系和运作方式。世界模型能帮助我们在日常生活中更好地理解周围环境、做出规划。
近年来,计算智能领域的研究学者们也受到认知科学的启发,对世界模型有了一些初步探索。
比如,和辛顿、杨立昆这一“加拿大分支团体”有些纷争的另一位人工智能大佬约尔根(Juergen Schmidhuber)在他2015 年的一篇强化学习论文《On Learning to Think: Algorithmic Information Theory for Novel Combinations of Reinforcement Learning Controllers and Recurrent Neural World Models》中对“世界模型”的设计展开了讨论。并在2018年的另一篇《世界模型》中作了更全面的阐述,他声称在 1990年的一篇 NIPS 的强化学习论文中便埋下了世界模型的概念。在2018年的那篇论文中,他引用了我非常喜欢的《理解漫画》一书当中的插图
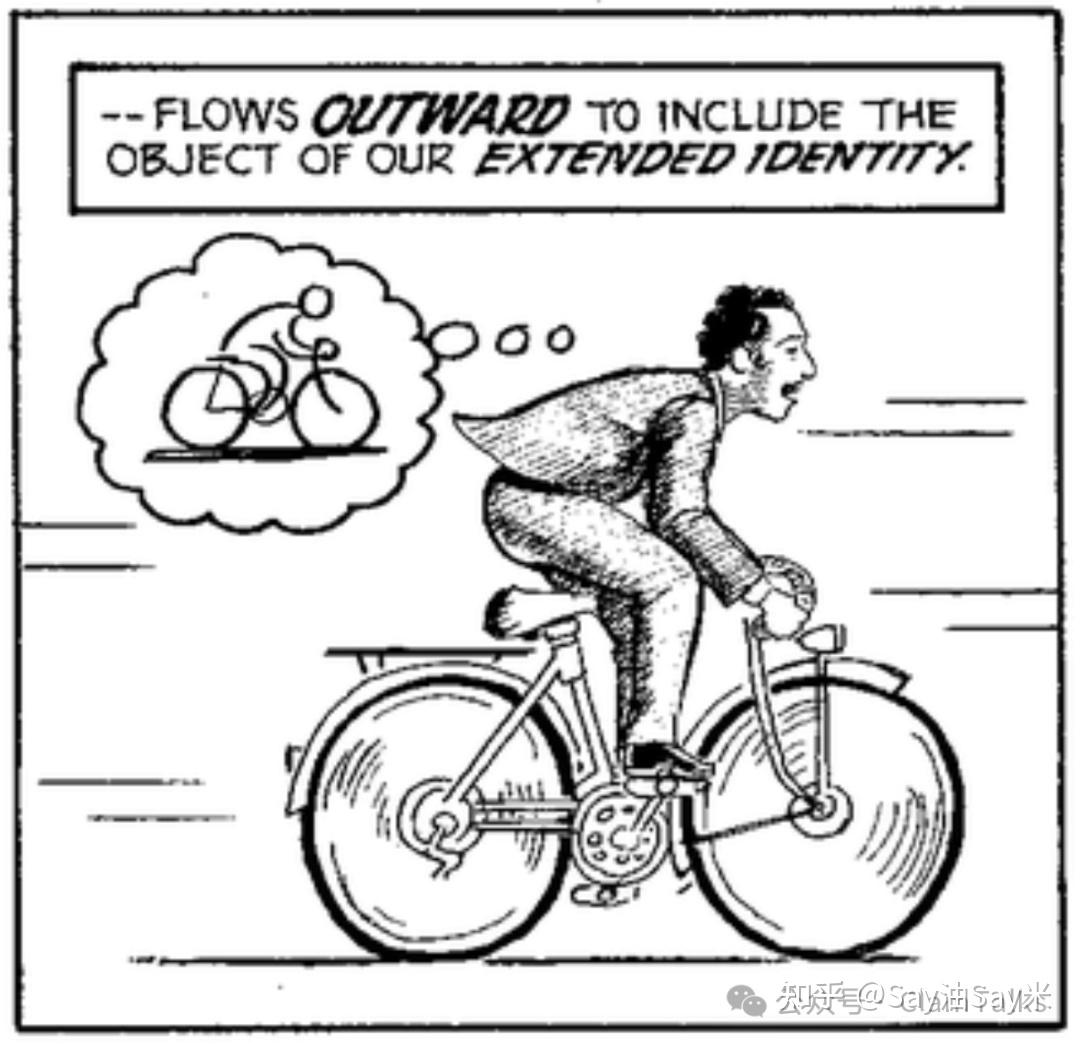 来自斯科特·麦克劳德的《理解漫画》
约尔根认为:人类(或者智能体)在世界中的行动,是围绕某个能够描述外部世界的抽象模型展开的。这个“世界模型”可以经由无监督学习(不借助外部标记,从大量原始数据中挖掘潜在数据模式和规律的一种学习过程)而得到,抽象地描述了外部世界环境表示(想象用乐高模块在一个 50×50 厘米的小桌子上搭建一个你寝室环境的模型的样子)。智能主体要模拟甚至超越人类智能,离不开在“世界模型”上进行推理、预测和规划。
让我们回到开车的例子。许多驾驶新手对于车辆的空间整体模型是比较粗糙的,结果便是驾驶操作的不自信甚至失误。驾驶技巧熟练的司机则有着更为细致的驾驶模型,对于车身轨迹、速度的判断更加精准。这些都可以看作是某种关于外部世界模型的一部分。
显而易见,每个个体的世界模型由经验塑造,模型肯定是不一样的。
那每个个体只有一个世界模型吗?
世界模型,“一”还是“多”
在计算智能领域,有关世界模型的讨论几乎假设(或者隐含假设)每个智能体只维护一个世界模型。插一句,在我看来,计算智能领域主要争论的应该是:算力or机制,谁是第一位的?
支持算力第一位的观点,比如强化学习的创始人理查德·萨顿认为21 世纪人工智能新的浪潮主要归功于算力与数据的突破,算法发展的加成相比来说并不显著。再比如,践行规模定律(scaling law)理念的OpenAI团队也坚定认为“大力能够出奇迹”,他们的一系列技术里程碑表明了在算力规模足够大的前提下,智能机器的表现将出现质变。
支持机制第一位的观点(比如港大的马毅教授),围绕的是计算智能极简主义——即智能是通过极简的而且可解释的原理实现的。
目前的大部分讨论似乎并未涉及当单个智能体有多个世界模型如何兼容并存的问题。
那么在计算智能领域之外呢?
美国神经科学家和科技企业家霍金斯2021年出版的《千脑智能》一书中提出了“千脑模型”:在人类大脑中,存在着成千上万各异的模型,以某种方式存在于人大脑皮层的皮质柱和相关神经细胞中,这些模型的协同作用引导了人的思考和决策,进而实现了智能。
这个理论直观上也好理解:人们在日常中按照不同情境的特点,激活了对应的世界模型展开行动和思考。
某种意义上,这些世界模型可以说是我们唯一能把握的「现实」——甚至可以据此推导出“我们的世界是被设计出来”的观点。
当然,霍金斯提出的人脑智能底层机制的框架(结合他的另一本书《新机器智能》)主要综合了既有神经及认知科学的发现,他的理论中仍有相当一部分有待证实(更像是设计好框架在找证据)。
此外,在2010 年出版的《大设计》一书中,霍金和蒙洛迪诺分析了“依赖模型的现实主义”。在这一观点下,我们所接受和经历的现实是基于这些模型(主要指的是能够被一致地描述、共享与证伪的模型)完成解释的。当几个模型在描述某一特定主题时,会引出多个同样有效的“现实”。因此,谈论一个模型的“真实性”是没有意义的,因为我们永远无法绝对确定任何事情。唯一有意义的事情是模型的实用性(可以看成“工具属性”)。
具有工具属性的世界模型,往往不是客观世界的忠实表述。
英国统计学家乔治·博克斯在《基于监测和调整的统计控制》中表示:所有的模型都只是近似。不管是隐含的还是明确说明的假设,从来都不是完全准确的。所有的模型都是错误的,但有些模型是有用的。所以你需要问的问题不是“这个模型真实吗?”(它永远不是)而是“这个模型对于这个特定应用来说足够好吗?”
那同一个个体的多个世界模型之间,需要是互洽的吗?
我认为它们总是在持续地变化,实现逻辑上的严格互恰似乎也没有必要。
支持世界模型在持续变化的部分观点,也源于神经心理学:生物脑会通过外部刺激导致的生物或生化变化,形成的认知信息单元,也被称作记忆痕(engram,最早据说由德国进化生物学家理查德·西蒙提出),是脑中储存记忆的方式之一。而大脑在面对不同情境时,被激活的一组记忆痕或许正对应了一部分的世界模型。
反过来说,模型也不总是快速变化的,有些模型借助特定的手段可以“外化”——被一致地描述、验证并且在个体间传播,最终导向了某种实现的技术,甚至反过来成为“锁死”社会群体多年的「成见」。
在这么多讨论的声音当中,我们似乎很难断言当前的智能机器已经形成了一套完备的世界模型。
尽管如此,从智力方面来看,生成式人工智能模型吞食了大量有关人类世界的信息,它们的显性知识储备已经超越了任何一个人,甚至有人相信它们就是通用人工智能的雏形。
那么,在他们的世界模型里包含了什么样的知识呢?拥有这些知识与拥有(人类智能的)理解能力之间有什么概念上的鸿沟吗?
智能机器的知识结构
对于智能机器掌握知识与拥有智能之间的关系,来自耶鲁大学的研究学者们在另一篇题为《From task structures to world models: What do LLMs know?》的文章中进行了讨论。切入点是:在什么意义上,现有的生成式大模型拥有知识?
在他们看来,大模型所掌握的知识只能被称作「工具知识」(instrumental knowledge)——也就是由一系列其所能展示的能力(例如语言能力,以及和具体任务相关的能力)而定义的知识。工具知识一词来源于哲学认识论学家的一些讨论和观点。这里就不展开了。
或许有人会问:“为什么这么定义?”
我认为多半是大模型是围绕「对下一个词的预测」这一特定任务展开行动的。在这些研究学者们看来,大模型仍旧是工具,而非人类这样的超越工具的主体。后者掌握的才是「世界知识」(worldly knowledge)。
为什么是工具呢?
因为他们认为在譬如跨语种机器翻译这样的任务中,大模型所学习到的知识仅仅是不同语言词汇和句法之间的某种复杂的概率性映射,在不还原原文内容的前提下,通过运算和符号变换完成了翻译。
举个例子,在翻译某本小说描写夏夜河畔浪漫故事的段落时,大模型并不会因为文字而调动出想象或者曾经的体验,然后将这些脑海中的中间产物转变成另一种语言的文字。
由此看来,理解似乎还与想象和唤起记忆有关。
如果智能机器拥有的仅仅是工具知识,那它们的知识与人类真正的世界知识的本质区别在哪里?
还是以语言为例。人在对话时,关注对方说了什么、语言语法模式外,下意识地还受到周围环境变化、对话内容中自己感兴趣内容的影响。然而,机器在对话时,主要关注对方说话内容和语言语法模式,以及训练和对话数据中产生的“对话接龙”的可能性和出现频率。
如果今天的智能机器与人类的世界模型与知识结构仍相去甚远,那么它们该做哪些准备,才能拥有接近人类的世界模型——进而理解这个世界?
掌握人类的世界模型
要回答这个问题,我们得看看认知科学领域的一些前沿观点。
在2016年行为科学顶级期刊《Behavioral and Brain Sciences》上美国纽约大学、麻省理工和哈佛大学的研究者们联合发表了一篇题为《Building Machines That Learn and Think Like People》的文章。
作者们围绕“人类智力发展过程中,最核心的要素有哪些?”进行了讨论,并把这些核心要素作为智能机器获得人的学习与思考能力的参考。
在去年,德国图宾根大学的研究者们发表了另一篇题为《Have we built machines that think like people?》的文章。他们基于那些核心要素测试了若干个现有的多模态大模型,结论是目前的智能机器只实现了人类智能的基础版本。
下面我们来简单看一下这三类核心要素。它们与世界模型密切相关。
第一类要素被称作“发育启动软件”。这类要素被看作是智能机器设计需要建立的基石,也是人类幼儿前几年大脑发育阶段形成的重要能力。
“发育启动软件”主要包括两种直觉:
1. 人们对客观世界规律的基本物理直觉。直觉不总是正确的,但它们应该足够帮我们完成日常生活中的大部分判断和预测,比如重力导致苹果从树上掉下来,手里的玩具被丢出去会往远处滚而不是垂直掉在地上,再比如站在悬崖边有随时可能跌落下去的危险等等。
2. 人们对生命物/非生命的辨别、对他人意图完成初步判断的心理直觉。比如对于他人亲社会、中立和反社会行为的一些判断能力。这一类的判断能力,通常被认为是从视听细节、情境感知等各种稀碎的信息当中习得的。
构建发育启动软件的观点和图灵的看法是类似的。图灵认为构建通用智能机器并非要一步到位。他说:“我们想要的是一台能够从经验中学习的机器...能像孩子一样发展。”也就是先构建出如人类幼崽一样的儿童机器(child machine),它们具备了学习与推理的基础能力,便能通过自我探索和发展成为更高阶的智能体。
站在世界模型的角度,当前智能机器围绕给定的上下文进行学习如何响应输入,似乎是远远不够的。它们还需要能够收集注意力之外(比如对聊天机器人而言,对话之外的)的信息,整合这些信息来判断对话者的意图。当它们接入摄像头或者环境信号传感器的时候,能够对周围环境动态的下意识判断和预测。
或许,我们的「理解」能力和某些直觉式的推理,正是基于这些注意力之外的信息整合实现的。我相信是它们赋予了我们更丰富的上下文信息,也反过来影响着我们的注意力分配。然而,目前的智能机器似乎还做得不够好。
第二类要素是“快速学习能力套件”。这是“快速建立环境模型”能力的基石。
这一“套件”大概包含了三类能力:第一个是组合能力。人们并不总需要完全从零开始学习新事物。我们下意识地会通过类比或者拼凑已有的经验,快速建立对新事物的模型。对世界模型而言是类似的。比如第一次进入一家新的咖啡店,我们的大脑并不会直接从头建立环境模型,我们对于店内的样式是有经验预期的,并靠我们对周围持续的观察而增量式地更新对环境的印象。除了情境,概念上也是相似的。对概念的重新组合和类比,往往也带给我们不一样的创意和发现。我认为,这不仅是“快速建立环境模型”的关键,也是持续更新世界模型的重要途径。目前的生成式人工智能(不管是视觉上的,还是语言上的)或许已经部分模仿了这种能力。第二个是因果推理能力。这是比物理直觉和心理直觉更高阶的能力。因果推理意味着我们可以假想未曾发生的情境,并且演绎一系列行动后的潜在后果。这被看作论证智能机器理解世界与否的关键。某种意义上,一个世界模型应该能够支持因果推理,并且整个过程是自洽。目前的生成式大模型还没有成功地融入因果推理机制的设计。它们具备推理能力的证据停留在它所产生的思维链(也就是分步骤给出针对某个回答的推理过程)。一些研究验证了它们具有一定的推理能力,但仍不是很完善。第三个是元学习的能力,即通过提前学习相关任务(或相关概念)来加速学习新任务或新概念的能力,也就是人们说的“举一反三”的能力。这个能力和组合能力是密不可分的。
第三类要素被称作“有效思考要素”。这部分主要关于如何在深度思考和快速反应之间进行权衡的能力。如果每个人有不止一个世界模型,那么当人们在快速搭建世界模型时,将面临着一个权衡——是用精密的世界模型进行深度推理,还是用粗糙的模型进行快速决策。这在卡尼曼的《思考:快与慢》中有深入的讨论。不那么恰当地说,这就像在选择清晰度或者视野不同的图像进行解析和处理。
对不同的清晰度和视野的选择,似乎指向了更为人类大脑中另一个重要但至今仍令人费解的机制——注意力机制。
事实上,回头想想,不只有效思考要素,前两类要素中的每一种能力,似乎或多或少地与注意力有关... 甚至可以说,如果智能的本质是快速构建模型的能力,那么注意力机制似乎是实现理解的关键。
现有的许多人工智能模型中已经引入了注意力机制设计(例如在长短期记忆网络以及生成式模型的 Transformer 架构中)。这些注意力机制主要是为了帮助智能机器更有效地保留大量数据中的关键信息和知识。
然而,这与我们日常直观理解的人类的注意力或许有点出入。人类的注意力,可以说是许多人引以为傲的主体性和自由意志的重要特征。人们“主宰”着自己的注意力,但注意力似乎也受到某种驱动力的支配(在先前介绍杨立坤的代理模型时,自驱力模块便涉及到了注意力)。
注意力帮我们指向所感兴趣的事物,也塑造了我们所选择和建立的世界模型,而世界模型是我们把握当下的基础,也赋予了我们的理解以意义。
甚至,在人们构建记忆力的过程中,注意力也起到了非常重要的作用。
今天先到这,下回我们顺着「注意力」,继续谈谈智能机器的「记忆」。
欢迎关注蛤蜊说,咱下次见!
http://weixin.qq.com/r/GR2IkGfEvTrCrSPz90gL (二维码自动识别)
版权所有,转载请私。