YouTube 订阅用户突破 1000 人,观看时长突破 4000 分钟——无掉粉现象
DESCRIPTION / 资源参数说明
前言: 抱抱脸团队的transformers 系列
下期预告:[NLP]BERT详解之二:分词篇-源码解读
BERT stands for Bidirectional Encoder Representations from Transformers. BERT自从Google放出来之后,热度一直很高,都搞出个词“BERTology”了。原论文提到BERT的贡献主要有三:(1)真正意义上的双向语言模型,demonstrate the importance of bidirectional pre-training for language representations;(2)fine-tuning很方便;(3)效果好,BERT advances the state-of-the-art for eleven NLP tasks.
个人认为BERT的灵魂就在于多层双向transformer编码器的模型架构+MLM(masked language model)和NSP(next sentence prediction)这两个预训练任务。本文将沿着原文的框架展开,最后进行一点Q&A。
目录模型架构:多层双向transformer编码器输入表示预训练任务:MLM+NSP预训练过程fine-tuning 过程Ablation StudiesQ & A
BERT's model architecture is a multi-layer bidirectional Transformer encoder(多层双向transformer编码器)。对于transformer参见原论文和The Annotated Transformer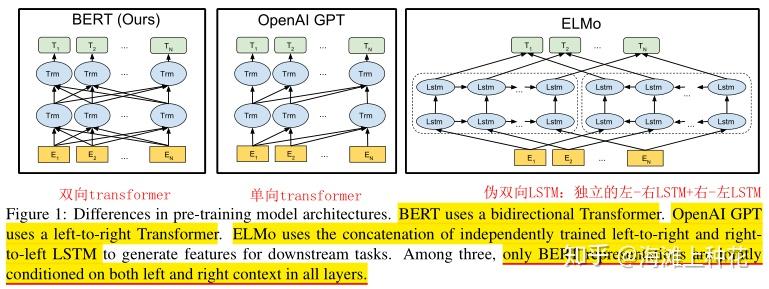
上图是BERT与以前的两个预训练模型OpenAI GPT和ELMo的比较,其中GPT采用了transformer但为单向;而ELMo采用了双向的LSTM,但这种双向只是the concatenation of independently trained left-to-right and right-to-left LSTM,是一种伪双向,而且LSTM在捕捉长距离依赖上是弱于transformer的;只有BERT是真正意义上的双向语言模型。
具体的,Google提供了一大一小两个BERT模型: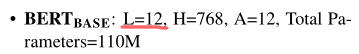
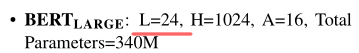
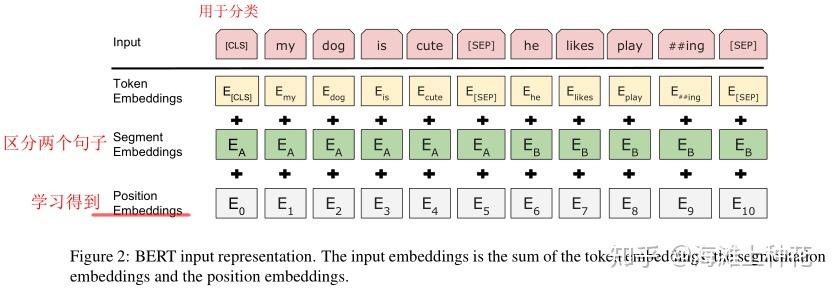
BERT的输入由三部分组成:Token Embeddings: We use WordPiece embeddings (Wu et al.,2016) with a 30,000 token vocabulary. We denote split word pieces with ##.wordpiece即sub-word units,是为了改善对稀有词的表示而提出的,详见Google's Neural Machine Translation SystemSegment Embeddings:用于区分两个句子Position Embeddings:位置编码,老生常谈transformer没有捕捉位置信息的能力,所以需要额外的位置编码,这里没有使用transformer论文中的正弦位置编码, 而是采用了learned positional embeddings。
另外,注意几个特殊符号:
句首第一个token [CLS]:分类用的
句尾的分隔符[SEP]
直观来看,深度双向语言模型当然比单向的left-to-right模型或者由独立的left-to-right and right-to-left简单拼接而成的伪双向模型更powerful。但不幸的是,标准条件语言模型只能从左到右或从右到左进行训练,因为双向条件将允许每个单词在多层上下文中间接“看到自己”。
为了解决这个问题,Google的研究者采取了一个直接的方式:随机mask掉一定比例的input tokens,然后只预测这些被mask掉的tokens。这就是所谓的 “masked LM” (MLM),其实就是 Cloze task完形填空!
但这个办法存在两个问题:缺陷1:MASK造成了预训练与微调过程的失配,为了缓解这个问题,他们弄出了一个骚操作:并不总是将“masked” words 替换为真正的 [MASK]标记,而是在训练时随机选择15%的tokens,然后按照8:1:1的比例做以下三种操作:(1)替换为[MASK] token;(2)替换为随机词;(3)不变。至于为什么?作者没说,大概又是玄学吧!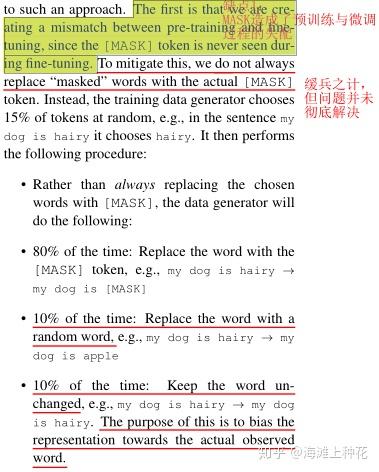 缺陷2:每个batch只预测15%的tokens,需要更多的轮次才能收敛。这个问题不大,性能的提升胜过了这点儿训练成本。
许多重要的下游任务,例如问答(QA)和自然语言推断(NLI),都是基于理解两个文本句子之间的关系的。这个没有办法直接由语言模型捕捉,所以他们增加了一个 next sentence prediction任务。具体的,对于训练语料中一对句子A和B,B有一半的概率是A的下一句,一半的概率是随机的句子。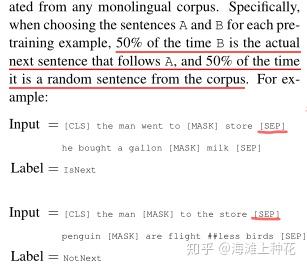
这个过程没啥好说的,注意几个点:预训练时建议使用文档级的语料: It is criti-cal to use a document-level corpus rather than a shuffled sentence-level corpus such as the Billion Word Benchmark (Chelba et al., 2013) in order to extract long contiguous sequences.训练时采用Adam,并做了 learning rate warmup over the first 10,000 steps, and linear decay of the learning rate激活函数采用gelu,详见:从ReLU到GELU,一文概览神经网络的激活函数损失函数取两个预训练任务MLM与NSP的loss之和: The training loss is the sum of the mean masked LM likelihood and mean next sentence prediction likelihood.
对于句子级的分类任务,fine-tuning很简单,如图3(b)所示,直接取第一个[CLS]token的final hidden state作为[CLS] word embedding,然后经过一个分类用的全连接层即可,预测的类别概率分布为: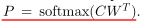
fine-tuning过程的大部分参数和预训练过程相同,除了下面这些: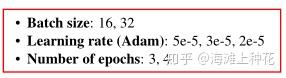
其他的下游任务需要进行一定程度的整容,弄成BERT接受的样子(哎,这看脸的时代)!具体后面会介绍。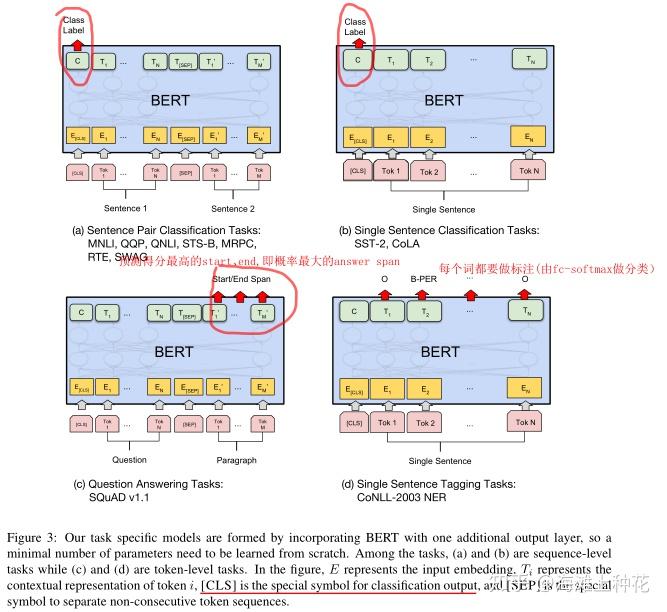
MNLI...RTE等双句分类任务的微调也很简单,如图3(a)所示。这里只简单提一下SWAG,常识推断任务,从4个选项中选择最合理的后续,简单改造即可: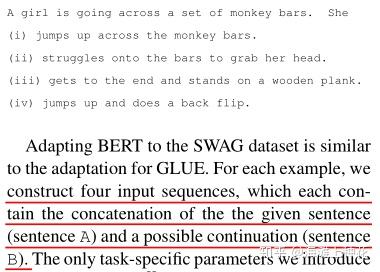
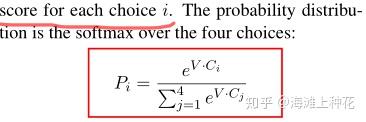
问答任务的微调如图3(c)所示,将问题作为句A,包含答案的段落作为句B,学习两个向量:start vector S和end vector E,通过这两个向量与第i个词word_i对应的final hidden vector Ti做softmax,求得word_i作为作为答案起点(终点)的概率,然后将概率最高的span作为预测结果。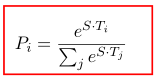
NER的特殊之处在于,要对每个词做tagging,如图3(d)所示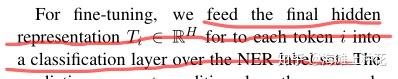
这个部分主要是为了验证bert中各个part的作用,直接贴实验结果:预训练任务的影响:下句预测(NSP)有利于文本推断、QA等任务,MLM双向语言模型优于单向LMmodel size的影响:越大越好。。。Effect of Number of Training Steps: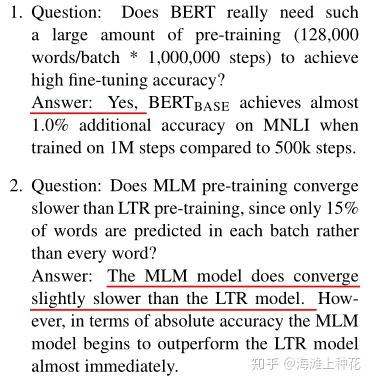
1.BERT的优缺点:
答:优点:(1)真正意义上的提供了双向语言模型;(2)fine-tuning方便;(3)效果好!
缺点主要就是MLM的问题:(1)[MASK]标记在fine-tuning过程中不会出现,这造成了预训练与微调过程的失配,目前的办法只能缓解,问题依然存在,训练时如果使用过多[MASK]会影响模型表现;(2)每个batch只预测15%的tokens,需要更多的轮次才能收敛。此外,(3)BERT对于文本生成并不是最佳选择;(4)分类时做平均可能要比只用[CLS] token的效果更好:averaging over the sequence may yield better results than using the [CLS] token。(3)、(4)详见bert tips.
2.BERT的输入是?
答:Token Embeddings+Segment Embeddings+Position Embeddings,详见正文
3. 为何要用 learned positional embeddings而不是transformer中正弦位置编码?
答:这个问题不清楚,我询问过Dr. Wenpeng Yin,他觉得无论是正余弦位置编码还是随机初始化再学习,都差不多
4. bert输入中的词嵌入哪儿来的?
答:
5. 用过BERT没?NER、QA怎么fine-tuning?在中文数据集上试过没?(阿里、蘑菇街等)
答:详见正文
6. 激活函数gelu? 为啥不用relu?
答:从ReLU到GELU,一文概览神经网络的激活函数
7. bert的损失函数?
答:详见正文和源码
8. transformer的各种问题
答:
9. MLM的问题你觉得可以怎样解决?
答:xlnet提供了一个不错的方案
10. bert分词的细节?
答:
11. bert模型初始化的细节:bert词向量的初始值是怎么来的?位置编码的初始值是怎么来的?(云从)
答:TODO
12. elmo,gpt,bert的关系,优劣(PDD)?
答:详见正文
13. bert、transformer的结构、细节、源码、实现(PDD)
答:bert源码后面会慢慢展开,transformer推荐“The Annotated Transformer”。
BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding
https://github.com/huggingface/transformers
https://github.com/google-research/bert
李如:【NLP】Google BERT详解
从Word Embedding到Bert模型—自然语言处理中的预训练技术发展史